숙소 후기 비속어 감지 모델 구현기
- CreateML
- BERT
숙소 후기 비속어 감지 모델 구현
문제 정의
- 사용자가 욕설·비속어를 작성하는 경우 → 즉시 차단
- 향후 확장: 숙소와 관련 없는 후기(스팸, 무관 텍스트) → 제출 제한
하나의 멀티라벨 모델로 처리하는 경우
- 욕설/비욕설 + 숙소 관련/무관 → 총 4개의 라벨 필요
- CreateML의 Text Classification은 멀티라벨 성능이 제한적 (오직 단일 라벨링만 지원)
Training Text Classifiers in Create ML - WWDC19 - 비디오 - Apple Developer
- 유지보수 불편(정책 바뀌면 모델 전체를 다시 훈련해야 함)
학습 알고리즘 선택 과정
| 알고리즘 | 설명 | 비속어 감지 적합성 |
|---|---|---|
| Maximum Entropy | 단순 통계 기반 BoW | 문맥 이해 거의 불가 |
| CRF | 시퀀스 태깅용 | 전체 문장 의미 파악 불가 |
| Static Embedding | Word2Vec/FastText | 단어 기반 / 오타·신조어 대처 불가 |
| ELMo | Dynamic embedding | 한국어에서 성능 준수하지만 한계 |
| BERT Embedding CJK (Korean) | 한국어 문맥 이해 최강 | 문맥형 욕설, 은어, 오타에 강력 |
undefined
💡 자세한 설명
🛫 1. Maximum Entropy (최대 엔트로피)
알고리즘: 확률적 분류 모델로, 주어진 제약조건 하에서 가장 균일한(엔트로피가 최대인) 확률 분포를 선택하는 방식입니다. 문맥 정보 등 다양한 특징을 반영해 확률 분포를 학습합니다.
사용처: 텍스트 분류, 품사 태깅, 기본적인 분류 문제. 특징이 다양하고 복잡한 경우 효과적입니다.
Conditional Random Fields (CRF, 조건부 랜덤 필드)
알고리즘: 시퀀스 데이터의 라벨링을 위해 각 출력(라벨)간 의존관계를 고려하는 판별적 확률 그래프 모델입니다. 전체 라벨 시퀀스의 조건부 확률을 최대화합니다.
사용처: 개체명 인식(NER), 품사 태깅, 문장 분할 등 문맥 의존적인 시퀀스 라벨링 문제에 적합합니다.
Static Embedding (정적 임베딩)
알고리즘: 단어별로 고정된 벡터를 사전 학습한 임베딩 (예: Word2Vec, GloVe)으로 문맥을 반영하지 않습니다.
사용처: 단어의 의미가 문맥에 크게 변하지 않는 경우, 비교적 간단한 NLP 태스크에 사용됩니다.
ELMo Embedding
알고리즘: 양방향 LSTM을 이용해 단어의 문맥 정보를 동적으로 반영하는 임베딩입니다. 문장 내 단어의 위치와 주변 문맥에 따라 임베딩이 달라집니다.
사용처: 문맥에 따라 의미가 변하는 단어 처리, 자연어 이해 향상, 문맥을 중요시하는 태스크에 사용됩니다.
BERT CJK (한국어 포함 CJK 언어용 BERT)
알고리즘: 트랜스포머 기반 사전학습 언어 모델로, 마스크드 언어 모델(Masked Language Model)과 NSP(Next Sentence Prediction)를 통해 깊은 문맥 이해를 합니다. CJK(중국어, 일본어, 한국어) 특성에 맞게 토크나이저 등 언어 처리 방식을 조정한 버전입니다.
사용처: 복잡한 문장 이해, 질의응답, 문장 분류, 기계 번역, 한국어 및 CJK 언어 특화 NLP 태스크에 최적.
- Maximum Entropy (최대 엔트로피)
- 알고리즘: 확률적 분류 모델로, 주어진 제약조건 하에서 가장 균일한(엔트로피가 최대인) 확률 분포를 선택하는 방식입니다. 문맥 정보 등 다양한 특징을 반영해 확률 분포를 학습합니다.
- 사용처: 텍스트 분류, 품사 태깅, 기본적인 분류 문제. 특징이 다양하고 복잡한 경우 효과적입니다.
- Conditional Random Fields (CRF, 조건부 랜덤 필드)
- 알고리즘: 시퀀스 데이터의 라벨링을 위해 각 출력(라벨)간 의존관계를 고려하는 판별적 확률 그래프 모델입니다. 전체 라벨 시퀀스의 조건부 확률을 최대화합니다.
- 사용처: 개체명 인식(NER), 품사 태깅, 문장 분할 등 문맥 의존적인 시퀀스 라벨링 문제에 적합합니다.
- Static Embedding (정적 임베딩)
- 알고리즘: 단어별로 고정된 벡터를 사전 학습한 임베딩 (예: Word2Vec, GloVe)으로 문맥을 반영하지 않습니다.
- 사용처: 단어의 의미가 문맥에 크게 변하지 않는 경우, 비교적 간단한 NLP 태스크에 사용됩니다.
- ELMo Embedding
- 알고리즘: 양방향 LSTM을 이용해 단어의 문맥 정보를 동적으로 반영하는 임베딩입니다. 문장 내 단어의 위치와 주변 문맥에 따라 임베딩이 달라집니다.
- 사용처: 문맥에 따라 의미가 변하는 단어 처리, 자연어 이해 향상, 문맥을 중요시하는 태스크에 사용됩니다.
- BERT CJK (한국어 포함 CJK 언어용 BERT)
- 알고리즘: 트랜스포머 기반 사전학습 언어 모델로, 마스크드 언어 모델(Masked Language Model)과 NSP(Next Sentence Prediction)를 통해 깊은 문맥 이해를 합니다. CJK(중국어, 일본어, 한국어) 특성에 맞게 토크나이저 등 언어 처리 방식을 조정한 버전입니다.
- 사용처: 복잡한 문장 이해, 질의응답, 문장 분류, 기계 번역, 한국어 및 CJK 언어 특화 NLP 태스크에 최적.
BERT 개념 정리 (특징/구조/동작 방식/종류/장점/BERT 모델 설명)
데이터셋
사용 데이터셋
📌 UnSmile 데이터셋 (Smilegate AI)
https://github.com/smilegate-ai/korean_unsmile_dataset
- 한국어 기반 혐오 글, 악성 발화 데이터
- 다중 라벨(여성/남성/성소수자/지역/욕설 등) 구조
→ 여기서 다른 혐오 발언, 지역 발언은 모두 drop하고 오직 욕설만 toxic 라벨로 전처리 진행
→ Clean 라벨과 합쳐서 1차 필터링
→ 라벨 : toxic, clean
📍 전처리 코드 (Python 기반)
# 파이프라인
# 1. UnSmile의 train/valid TSV 파일 로드
# 2. 타겟 라벨로 `"악플/욕설"`만 선택
# 3. `clean = 1`이면 clean 라벨
# 4. 나머지 혐오 라벨이 1이면 현재 목적에 불필요 → drop
# 5. HTML, 이모지, 특수문자 제거
# 6. 중복 문장 제거, 공백 다듬기
# 7. 최종 CSV(`clean_toxic_dataset.csv`) 생성
# 8. CreateML(Text Classification)에 바로 넣을 수 있는 구조로 저장

import pandas as pd
import re
import os

# -------------------------------------------------------------------------
# 설정 (Configuration)
# -------------------------------------------------------------------------
# 작업 경로 (현재 경로 기준)
BASE_DIR = os.getcwd()

# 입력 파일 리스트 (UnSmile 데이터셋 파일명)
INPUT_FILES = ['unsmile_train_v1.0.tsv', 'unsmile_valid_v1.0.tsv']

# 결과 저장 파일명
OUTPUT_FILE = 'clean_toxic_dataset.csv'

# 타겟으로 삼을 'Toxic' 라벨 컬럼명 리스트
# 사용자의 요청: "비속어 감지 모델 (욕설/혐오 여부만 판단)"
# "악플/욕설"을 주 타겟으로 설정합니다.
TARGET_COLS = ['악플/욕설']

# "clean" 여부를 판단할 컬럼
CLEAN_COL = 'clean'

# -------------------------------------------------------------------------
# 텍스트 전처리 함수 (Text Cleaning Function)
# -------------------------------------------------------------------------
def clean_text(text):
    if not isinstance(text, str):
        return ""

    # 1. HTML 태그 제거
    text = re.sub(r'<[^>]+>', '', text)

    # 2. 이모지 및 특수문자 제거 (기본적인 한글, 영문, 숫자, 문장부호만 남김)
    # CreateML은 이모지를 처리할 수 있지만, 노이즈를 줄이기 위해 제거합니다.
    # 유니코드 범위를 사용하여 이모지 제거 (간단한 방식)
    # 한글(가-힣, 자음/모음), 영문(a-zA-Z), 숫자(0-9), 기본 문장부호만 허용
    text = re.sub(r'[^0-9a-zA-Z가-힣\s.,!?\'"]', ' ', text)

    # 3. 반복되는 문자 축약 (예: ㅋㅋㅋㅋㅋㅋ -> ㅋㅋ)
    # 3회 이상 반복되는 문자는 2회로 줄임
    text = re.sub(r'(.)\1{2,}', r'\1\1', text)

    # 4. 중복 공백 제거
    text = re.sub(r'\s+', ' ', text).strip()

    return text

# -------------------------------------------------------------------------
# 메인 전처리 로직 (Main Preprocessing Logic)
# -------------------------------------------------------------------------
def preprocess_unsmile():
    print(f"🚀 데이터 전처리를 시작합니다... (Target: {TARGET_COLS})")

    dfs = []

    # 1. 데이터 로드 (Load Data)
    for file_name in INPUT_FILES:
        file_path = os.path.join(BASE_DIR, file_name)
        if os.path.exists(file_path):
            print(f"   - 파일 로드 중: {file_name}")
            # TSV 파일이므로 delimiter='\t'
            df = pd.read_csv(file_path, sep='\t')
            dfs.append(df)
        else:
            print(f"   ⚠️ 파일을 찾을 수 없습니다: {file_name} (건너뜀)")

    if not dfs:
        print("❌ 처리할 데이터 파일이 없습니다.")
        return

    # 데이터 병합
    full_df = pd.concat(dfs, ignore_index=True)
    print(f"   - 총 {len(full_df)}개의 데이터를 불러왔습니다.")

    # 2. 라벨링 로직 적용 (Labeling Logic)
    # 요구사항: toxic=1 -> "toxic", toxic=0 -> "clean"
    # 핵심 라벨(악플/욕설)만 사용하고 나머지는 제거(Drop)하거나 Clean으로 간주해야 함.
    # 명확한 학습을 위해:
    # - Case A: '악플/욕설' == 1  => "toxic"
    # - Case B: 'clean' == 1      => "clean"
    # - Case C: 그 외 (욕설은 아니지만 다른 혐오 발언이 있는 경우) =>
    #   사용자가 "나머지 라벨은 삭제"라고 했으므로,
    #   "비속어 모델"의 성능을 높이기 위해 Case C는 학습 데이터에서 제외(Drop)합니다.
    #   (욕설이 없는 혐오 발언을 'clean'이라고 가르치면 모델이 혼란스러울 수 있음)

    def get_label(row):
        # 타겟 컬럼 중 하나라도 1이면 toxic
        is_toxic = any(row[col] == 1 for col in TARGET_COLS)

        if is_toxic:
            return 'toxic'
        elif row[CLEAN_COL] == 1:
            return 'clean'
        else:
            return 'drop' # 욕설은 없으나 다른 혐오(지역, 성별 등)가 있는 경우 -> 제외

    # 라벨 생성
    full_df['label'] = full_df.apply(get_label, axis=1)

    # 'drop' 라벨 제거
    original_count = len(full_df)
    full_df = full_df[full_df['label'] != 'drop'].copy()
    dropped_count = original_count - len(full_df)
    print(f"   - 라벨 필터링 완료: {dropped_count}개의 모호한 데이터(욕설 없는 기타 혐오) 제외됨.")

    # 3. 텍스트 정제 (Text Cleaning)
    print("   - 텍스트 정제 중 (HTML, 이모지 제거, 공백 정리)...")
    full_df['text'] = full_df['문장'].apply(clean_text)

    # 빈 텍스트 제거 (전처리 후 내용이 없는 경우)
    full_df = full_df[full_df['text'].str.len() > 1]

    # 4. CreateML 형식으로 저장 (Export)
    # 필요한 컬럼만 선택: text, label
    output_df = full_df[['text', 'label']]

    # 데이터 분포 확인
    print("   - 최종 데이터 분포:")
    print(output_df['label'].value_counts())

    # CSV 저장
    output_path = os.path.join(BASE_DIR, OUTPUT_FILE)
    output_df.to_csv(output_path, index=False, encoding='utf-8')

    print(f"\n✅ 전처리 완료! 결과 파일이 저장되었습니다: {output_path}")
    print(f"   - 이 파일을 CreateML 앱에 드래그 앤 드롭하여 바로 학습할 수 있습니다.")

if __name__ == "__main__":
    # 필요한 패키지 확인
    try:
        import pandas
    except ImportError:
        print("❌ pandas 패키지가 필요합니다. 실행 전 설치해주세요: pip install pandas")
        exit(1)

    preprocess_unsmile()
Booking.com hotel review | Kaggle
- 한국 지역(여수, 제주도, 서울, 강릉, 부산, 속초, 경주, 광주, 인천, 군산, 춘천, 가평 등)에 대한 36,669개의 호텔 리뷰
- 대부분 3성급 호텔 이상의 데이터를 가지고 있음
- 라벨 :
hotel_namehotel_reviewcleaned_review - ❗ 단,
호텔 리뷰데이터셋이지호텔 리뷰가 아닌 반증 데이터 셋은 없음
→ 스마일게이트의 욕설 컬럼과 부킹닷컴의 호텔 리뷰 컬럼을 합쳐서 커스텀 데이터셋을 만들면..?
- 스마일게이트 욕설 컬럼(toxic) + 부킹닷컴의 호텔 리뷰(clean)
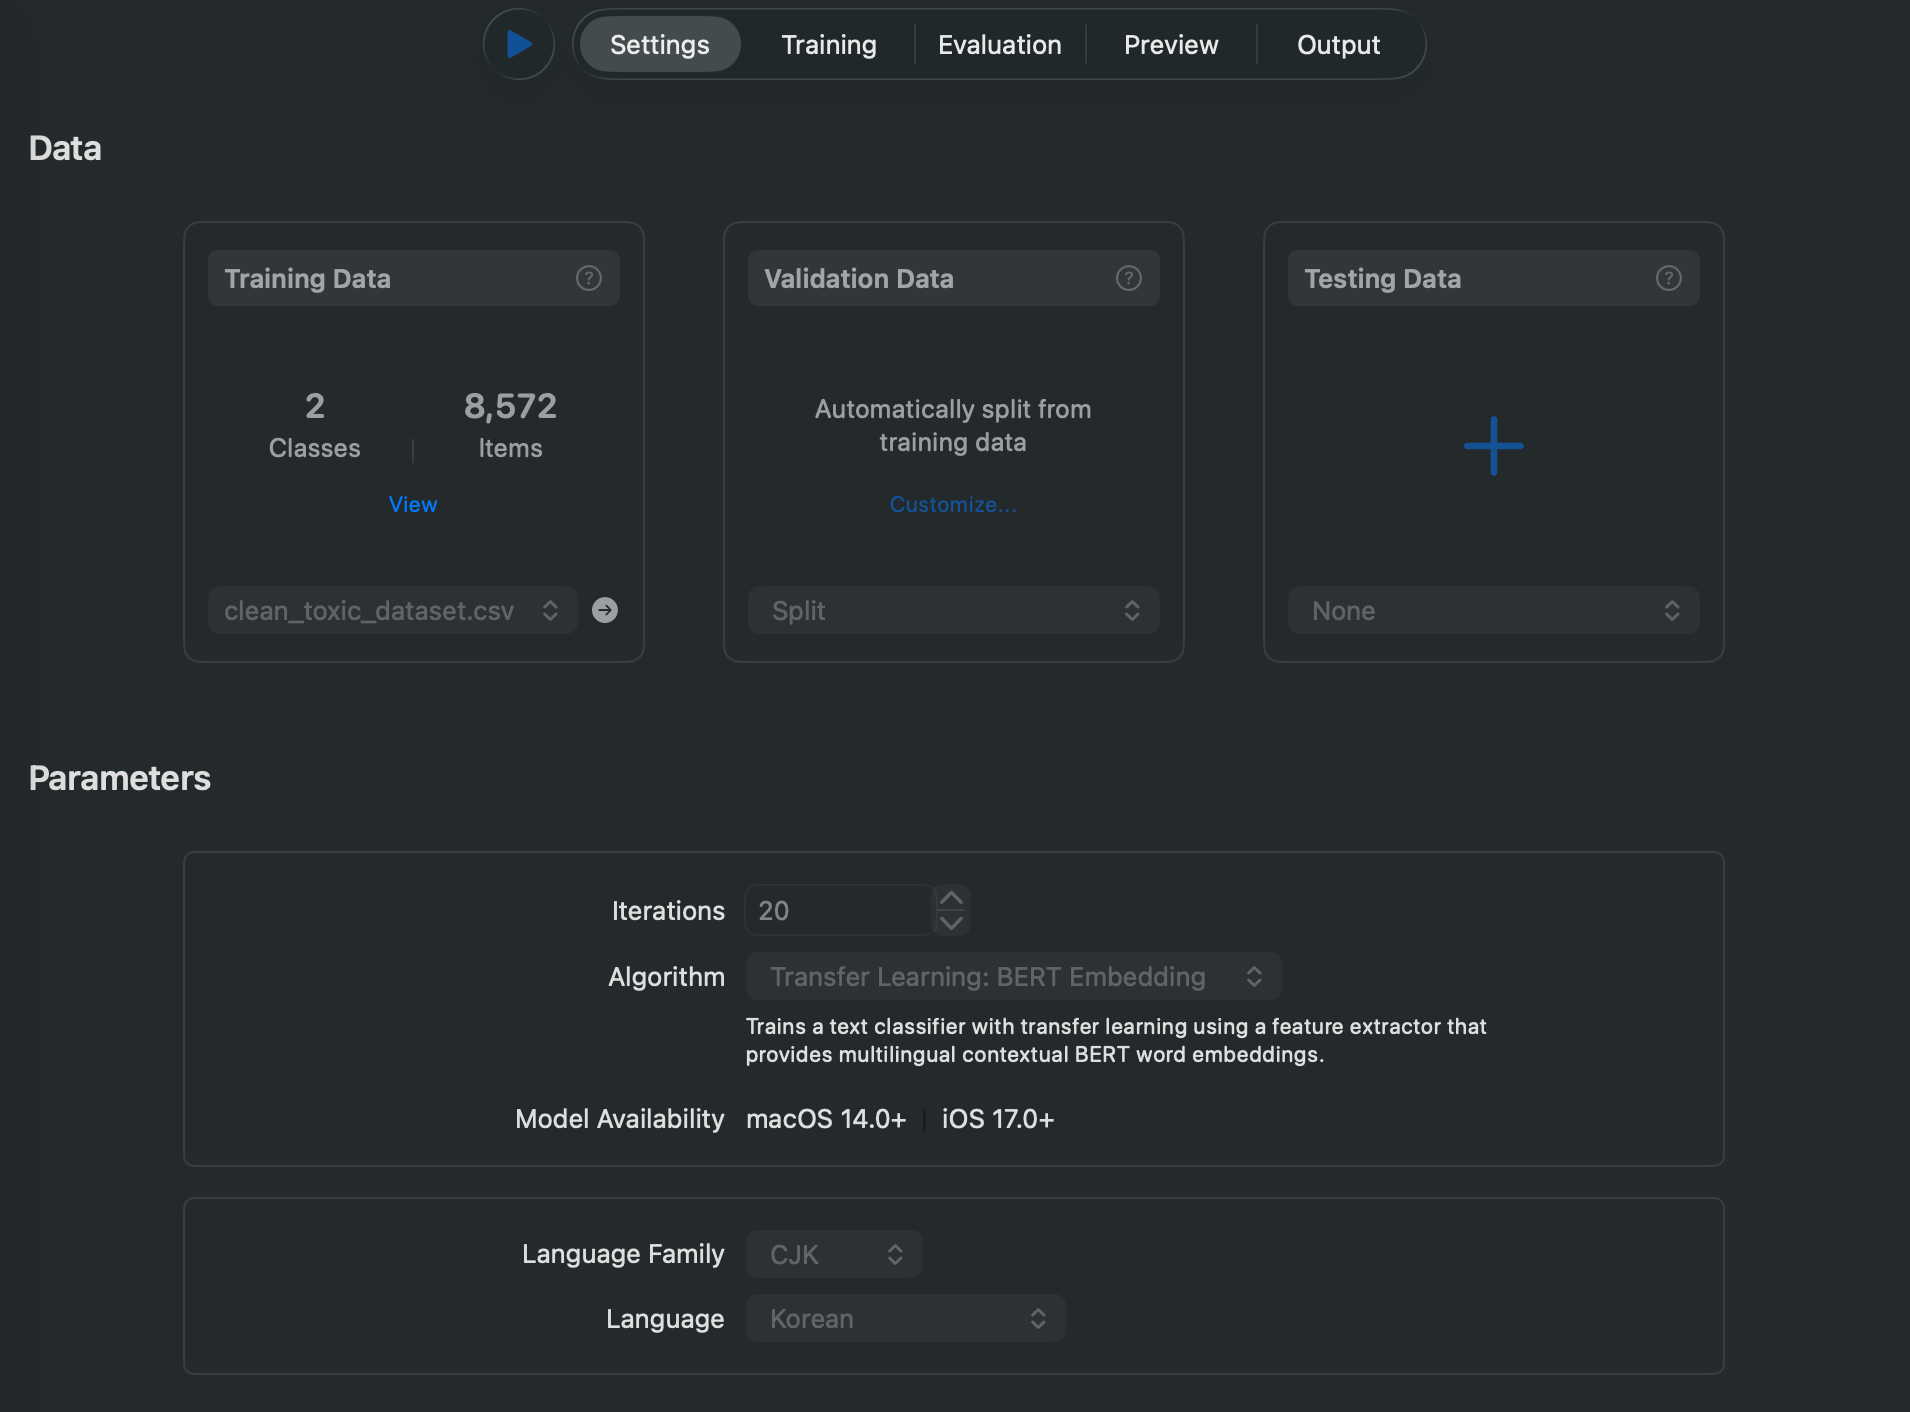
학습 설정 (모델 A)
- Algorithm: Transfer Learning – BERT CJK (Korean)
- Training/Validation Split: Auto
- Epoch / Iteration: 20회
- 데이터셋 :
오직 비속어(toxic)와 비속어가 아닌(clean) 경우의 데이터셋 (UnSmile 데이터셋 (Smilegate AI)
성능
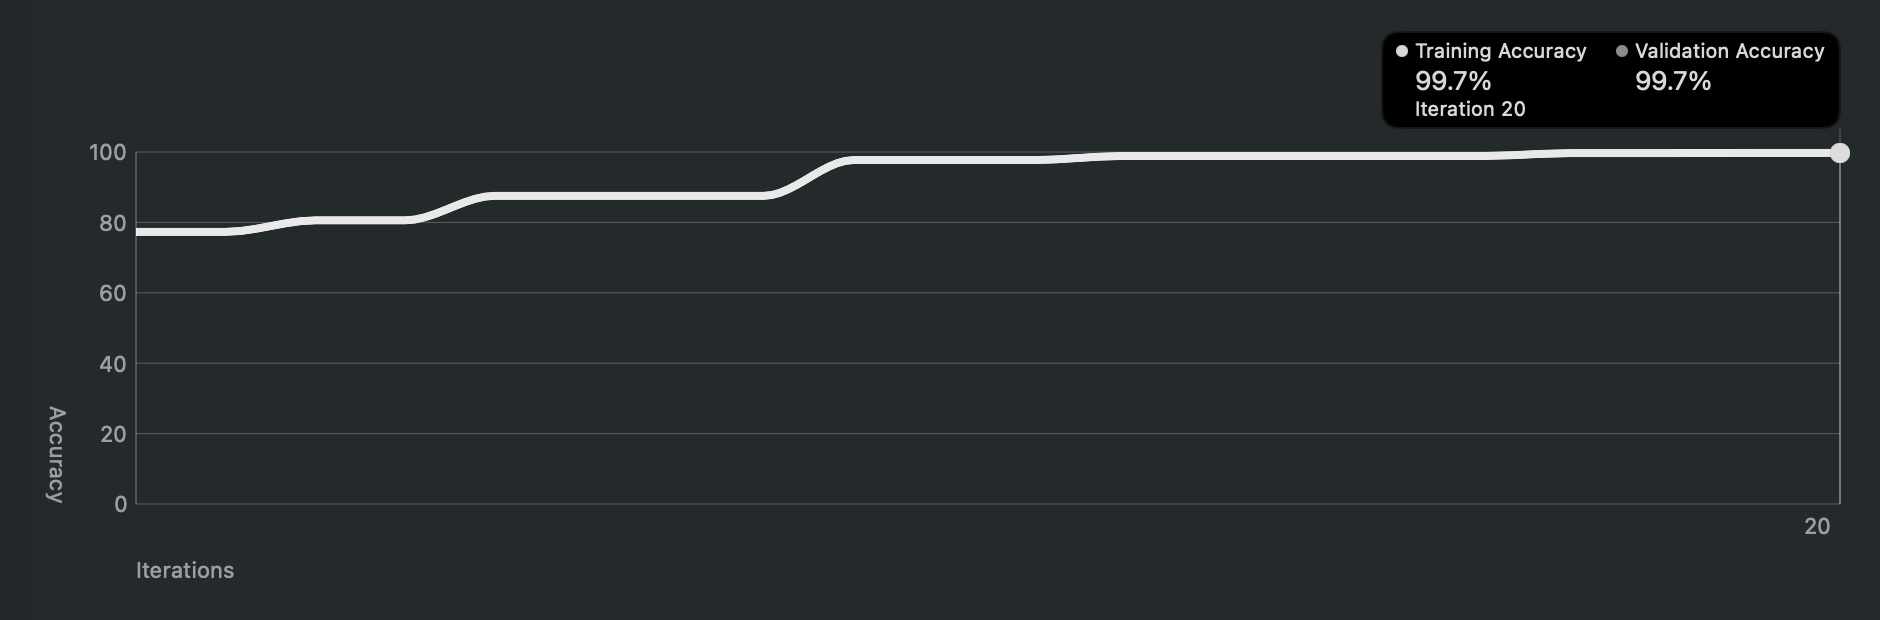
| Class | Precision | Recall | F1 |
|---|---|---|---|
| clean | 74% | 87% | 0.80 |
| toxic | 84% | 69% | 0.76 |
undefined- toxic Precision 84% (예측한 것 중 약 84%은 실제 욕설)
- toxic Recall 69% (약 31%은 욕설을 놓침)
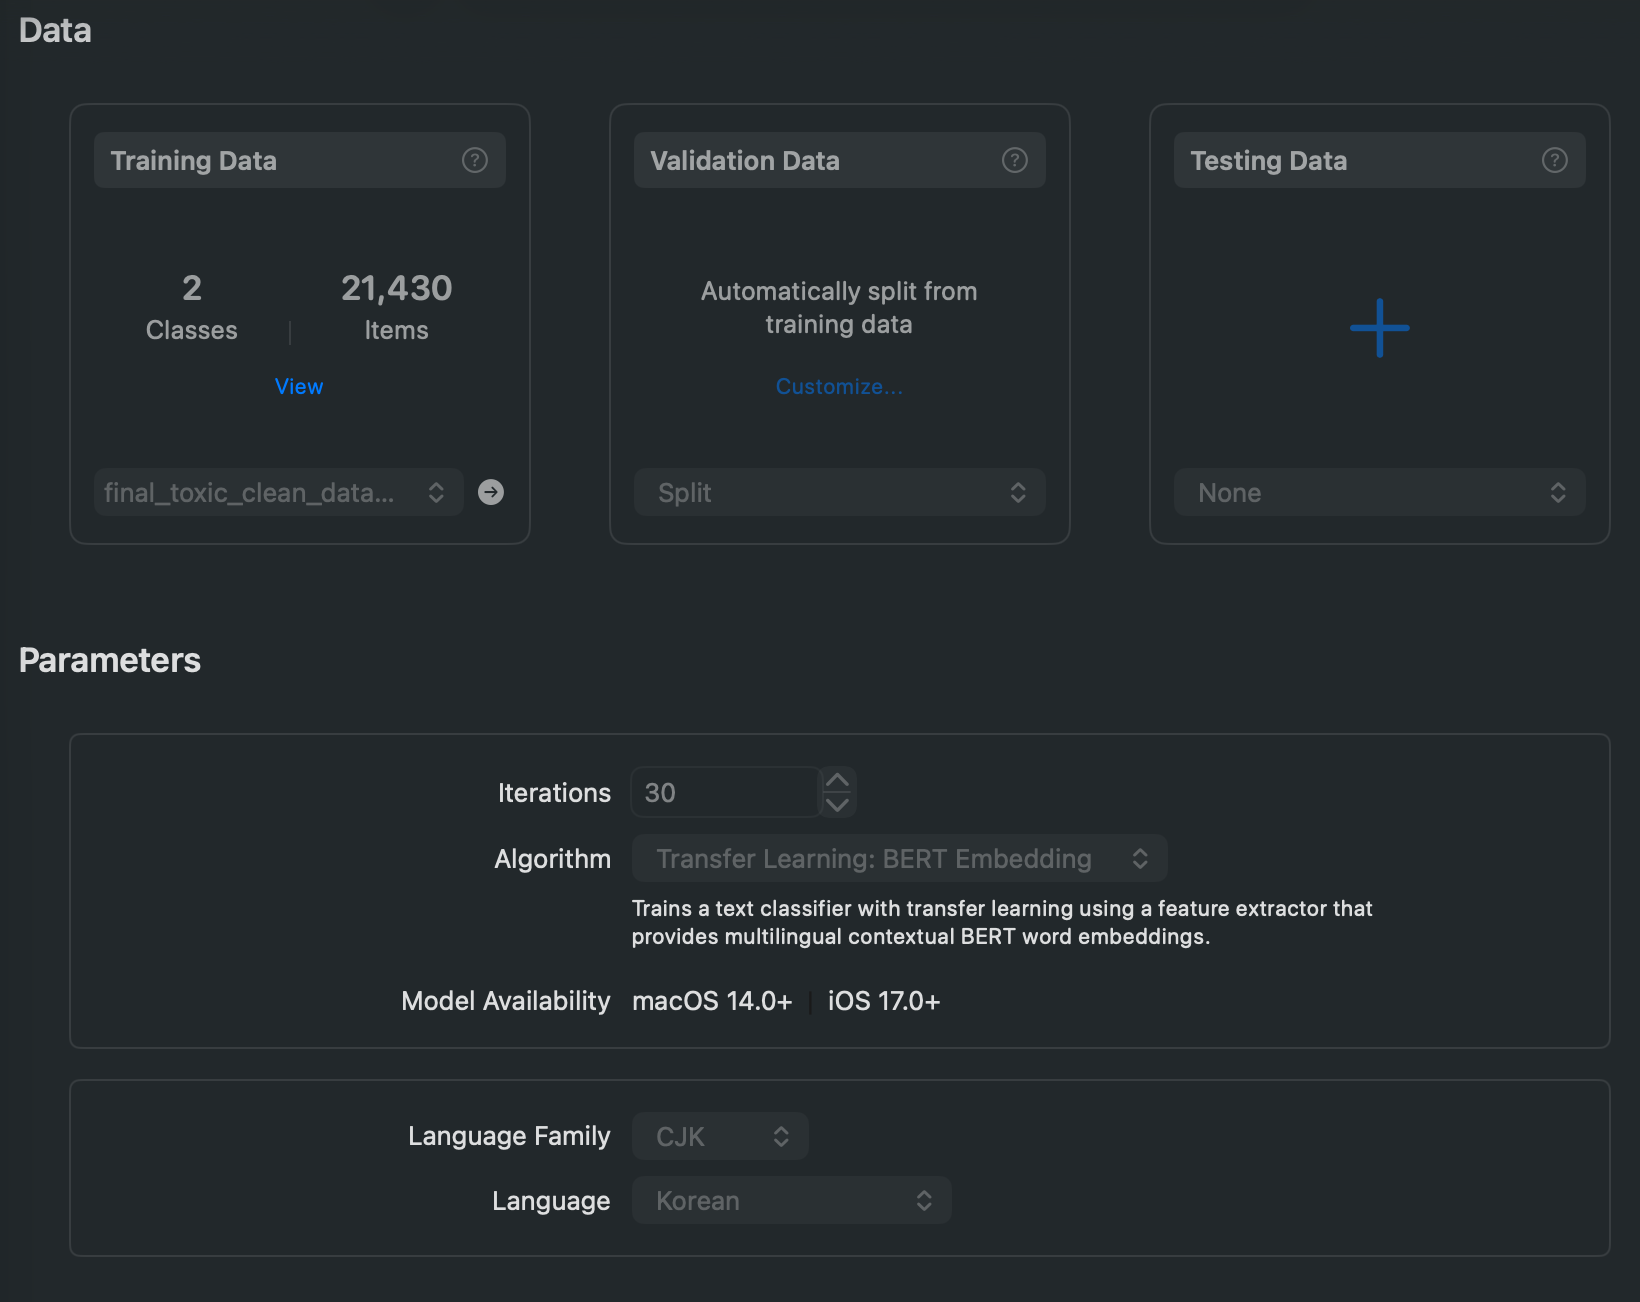
학습 설정 (모델 B)
- Algorithm: Transfer Learning – BERT CJK (Korean)
- Training/Validation Split: Auto
- Epoch / Iteration: 30회
- 데이터셋 : 스마일게이트 욕설 컬럼(toxic) + 부킹닷컴의 호텔 리뷰(clean)
성능
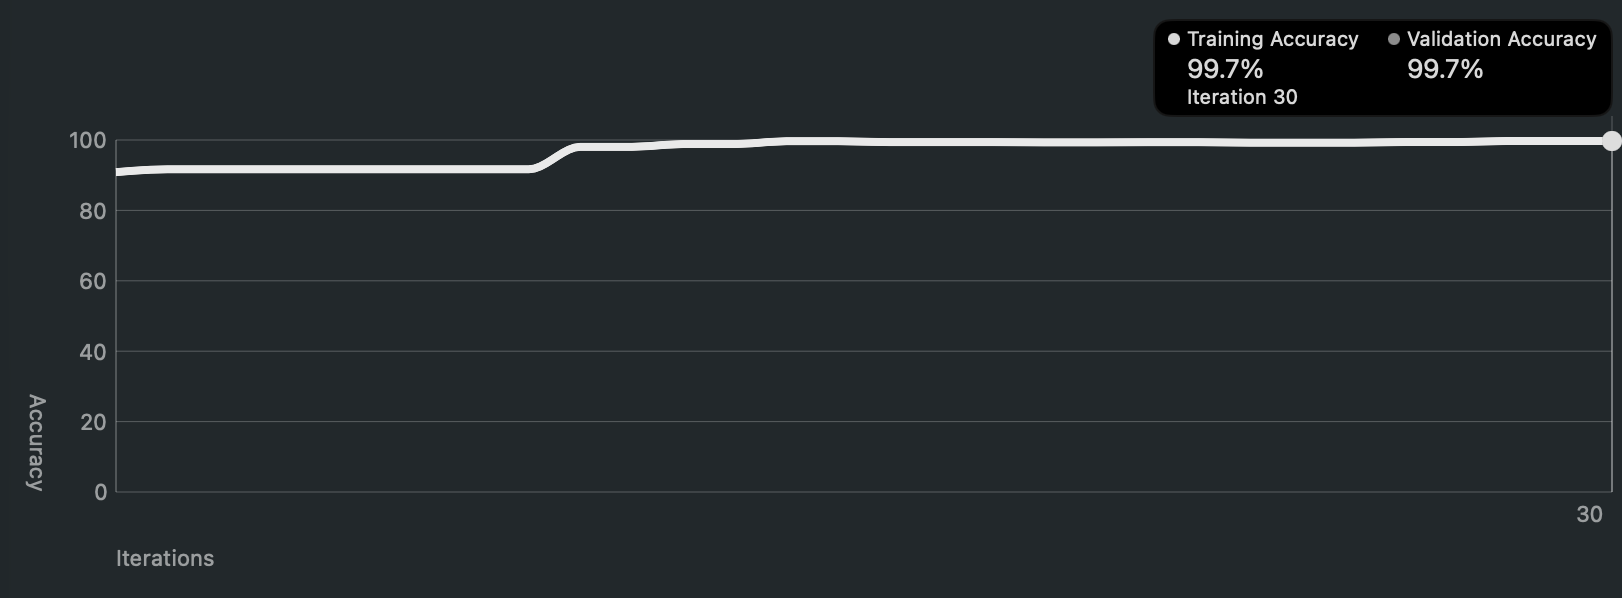
| Class | Precision | Recall | F1 |
|---|---|---|---|
| clean | 95% | 95% | 0.95 |
| toxic | 71% | 73% | 0.72 |
undefined- toxic Precision 95% (예측한 것 중 약 95%은 실제 욕설)
- toxic Recall 73% (약 27%은 욕설을 놓침)
🧪 테스트 점검표
모델 A
| 번호 | 후기 예시(모델 입력용) | 비속어가 아닐 확률(clean, %) | 비속어일 확률(toxic, %) |
|---|---|---|---|
| 1 | 진짜 서비스 최악이네요. 직원 태도가 너무 싸가지 없어서 기분 완전 나빴습니다. | 78 | 22 |
| 2 | 방이 생각보다 좁았지만 직원분들이 친절해서 전체적으로 만족했어요. | 100 | 0 |
| 3 | 난 이딴 숙소 처음 본다. 돈값을 못하네. | 84 | 16 |
| 4 | 체크인도 빠르고 방도 깨끗했어요. 다음에 또 이용하고 싶네요. | 100 | 0 |
| 5 | 콘센트 위치가 좀 불편했지만 뭐 그럭저럭 잘 지냈습니다. | 100 | 0 |
| 6 | 벽이 너무 얇아서 새벽까지 옆방 소리 다 들림. 이런 건 진짜 개선해야 합니다. | 94 | 6 |
| 7 | 개판이네 진짜. 온돌은 뭐고 난방도 안 되고 장난하냐? | 10 | 90 |
| 8 | 숙소 위치가 좋아서 이동이 편했어요. 다만 조식이 조금 아쉬웠습니다. | 100 | 0 |
| 9 | 이 숙소는 진짜 개같이 운영되네. | 19 | 81 |
| 10 | 화장실 물이 잘 안 내려가서 불편했어요. 빨리 고쳐주시면 좋겠네요. | 97 | 3 |
모델 B
| 번호 | 후기 예시(모델 입력용) | 비속어가 아닐 확률(clean, %) | 비속어일 확률(toxic, %) |
|---|---|---|---|
| 1 | 진짜 서비스 최악이네요. 직원 태도가 너무 싸가지 없어서 기분 완전 나빴습니다. | 97 | 3 |
| 2 | 방이 생각보다 좁았지만 직원분들이 친절해서 전체적으로 만족했어요. | 100 | 0 |
| 3 | 난 이딴 숙소 처음 본다. 돈값을 못하네. | 64 | 36 |
| 4 | 체크인도 빠르고 방도 깨끗했어요. 다음에 또 이용하고 싶네요. | 100 | 0 |
| 5 | 콘센트 위치가 좀 불편했지만 뭐 그럭저럭 잘 지냈습니다. | 100 | 0 |
| 6 | 벽이 너무 얇아서 새벽까지 옆방 소리 다 들림. 이런 건 진짜 개선해야 합니다. | 97 | 3 |
| 7 | 개판이네 진짜. 온돌은 뭐고 난방도 안 되고 장난하냐? | 3 | 97 |
| 8 | 숙소 위치가 좋아서 이동이 편했어요. 다만 조식이 조금 아쉬웠습니다. | 100 | 0 |
| 9 | 이 숙소는 진짜 개같이 운영되네. | 27 | 73 |
| 10 | 화장실 물이 잘 안 내려가서 불편했어요. 빨리 고쳐주시면 좋겠네요. | 100 | 0 |
임계 확률(threshold) 설정
- toxic ≥ 35 ~ 40% → 비속어 감지! Alert 출력
- clean ≥ 87 ~ 95% → 통과
→ 정확한 정책은 팀원들과 함께 이야기해보는걸로..?
더 좋은 데이터셋 없나..? ㅠㅠ