← Lab
CreateML을 사용한 이미지 분류 모델 만들기
실험2025.10.07
- CreateML
용어 정리
- 특징 추출기(Feature Extractor)
- 이미지, 오디오 등을 벡터로 바꿔서 LM에 넣는 모듈
- 왜 사용하는가?
→ 원시 데이터를 그대로 사용하면 차원이 너무 크고 노이즈가 많아서 학습이 매우 비효율적
→ 따라서 특징 벡터를 MLP나 로지스틱 회귀 등에 넣어 모델의 학습 효율을 더 끌어올리기 위함
- CreateML Image Classification에서 사용하는 특징 벡터 추출 모듈 종류
- Image Feature Print V1
- macOS 10.14+, iOS 12+
- Image Feature Print V2
- macOS 14+, iOS 17+
- V1보다 출력 임베딩 크기가 작아서 특징 벡터를 저장하는데 필요한 메모리가 적고 정확도가 올라감
- 🤔 정확하게 어떤 특징 벡터 추출 알고리즘을 사용하는지는 아무리 찾아봐도 안나옴.. ResNet인지 MobileNet 계열인지 안나옴..
- 훈련 데이터(Training set)
- 모델의 가중치를 학습하는 데 사용되는 데이터셋으로, 알고리즘을 통해 실제 패턴을 학습하는 용도
- 하이퍼파라미터 조정이나 성능 평가용이 아님.
- 해당 데이터를 통해 모델이 학습함
- 검증 데이터(Validation Set)
- 훈련 중 다양한 모델과 하이퍼파라미터를 비교하고
가장 좋은 모델을 선택하는 데 사용하는 데이터 - 훈련 과정에서는 가중치를 업데이트하지 않지만 모델 선택과 튜닝 측면에서는
seen데이터 역할을 수행 - 테스트 데이터(Test Set)
- 모델 학습과 튜닝이 모두 끝난 뒤
전혀 사용되지 않았던 데이터로 모델의일반화성능을 평가하기 위한 데이터 - 검증이나 선택 과정에 전혀 관여하지 않았으므로 특정 편향 없이 모델이 잘 동작하는지 평가할 수 있음
- 비율이 중요한 이유
→ 데이터셋을 훈련/검증/테스트로 나눌 때의 비율은 곧 얼마나 많은 데이터를 학습하고 검증하고 평가할 것인지를 나타낸다.
→ 8:1:1 이라면 전체 데이터 중 80%를 학습용, 10%을 검증용, 10%을 평가용으로 활용한다.
→ 학습용 데이터 비율이 커지면 일반화의 가능성이 높아짐 → 과적합 발생 가능
→ 검증 데이터가 너무 적으면 온전한 성능 평가가 이뤄지지 않을 가능성이 높아짐.
→ 그 반대로 검증 데이터가 너무 많으면 학습할 데이터가 부족하여 모델이 정상적인 학습을 못함.
🔨 이미지 분류(Image classification) 모델 만들기
📌 1. 첫 번째 모델 (8:1:1)
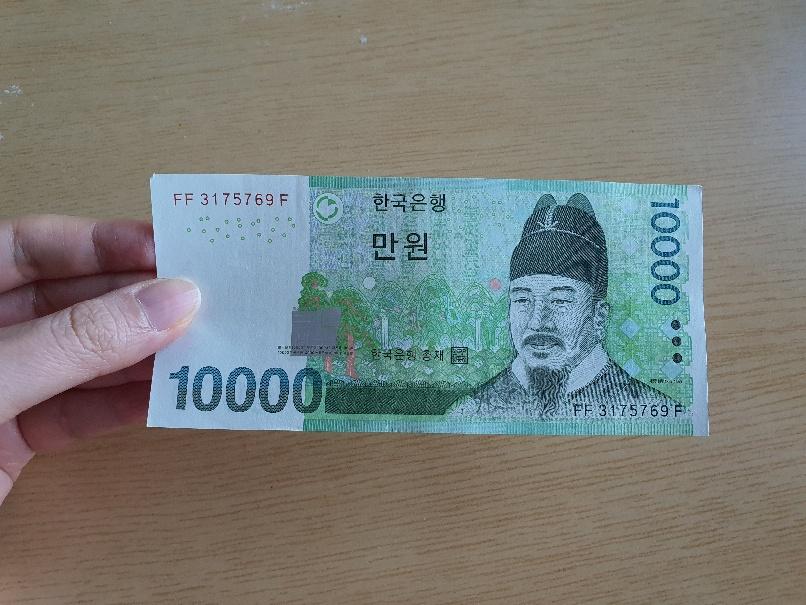
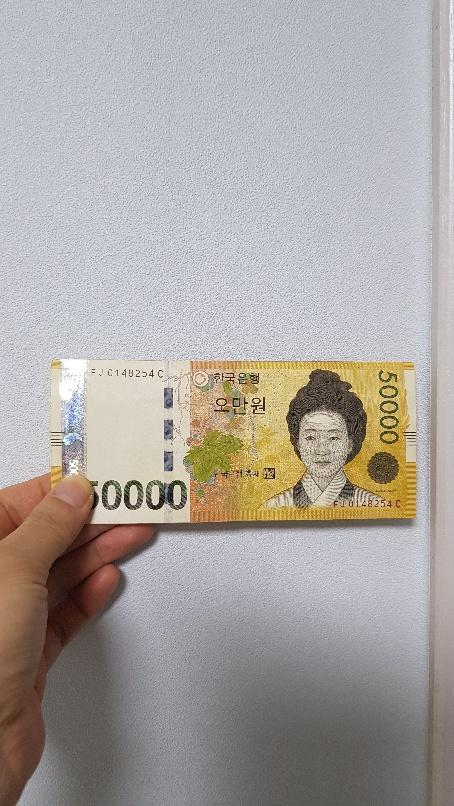
- 원본 데이터셋 : 1000, 5000, 10000, 50000원권 이미지 약 1만장
- Feature Extractor: Image Feature Print V2
- Training, Vaildation, Testing 비율 :
(8:1:1) - Iterations : 45
- Augmentations : Add Noise, Blur, Crop, Expose, Rotate
- Class: 001_50000, 002_10000, 003_5000, 004_1000
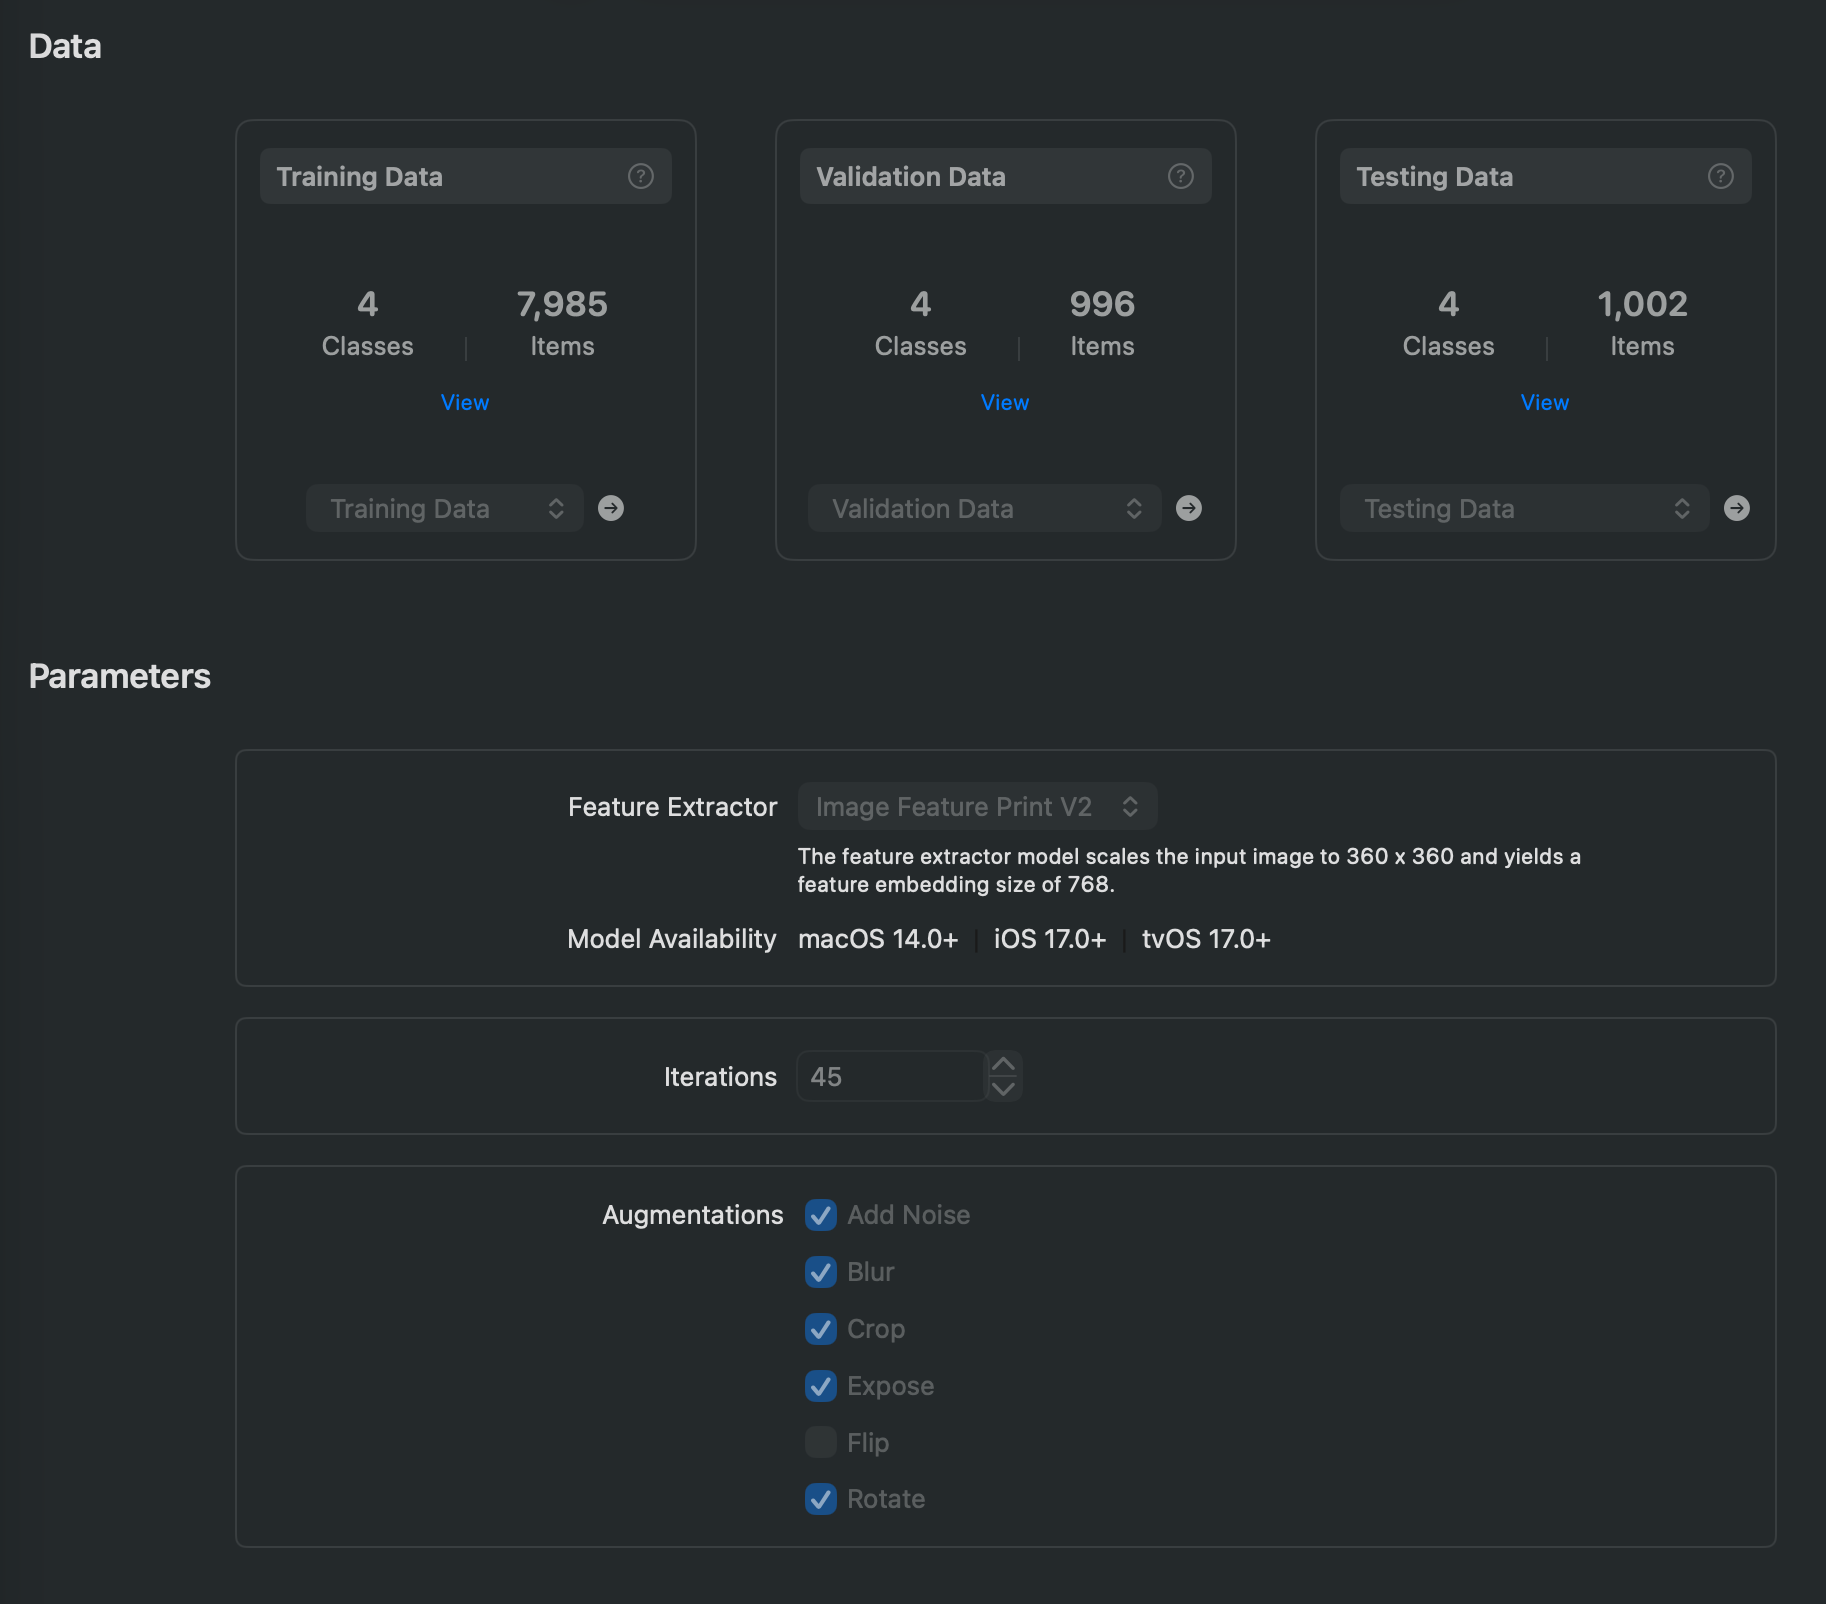
- 모델 훈련 결과
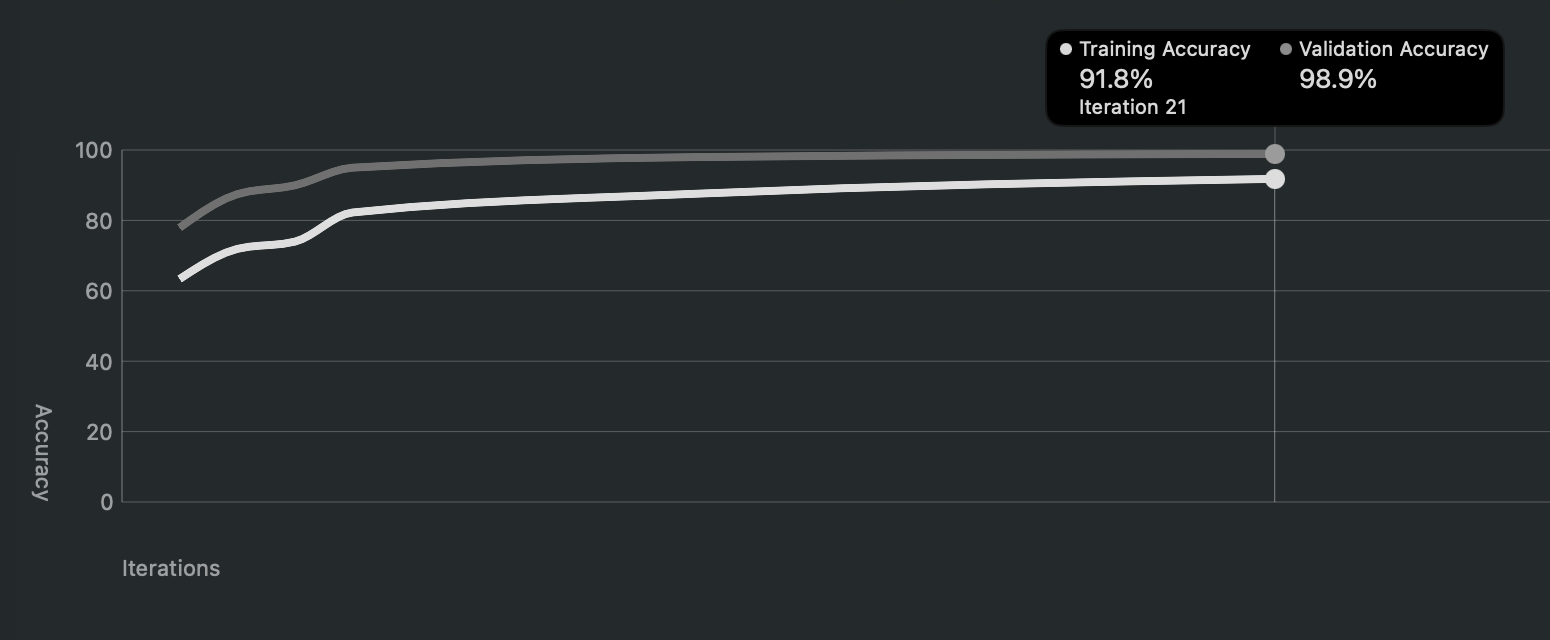
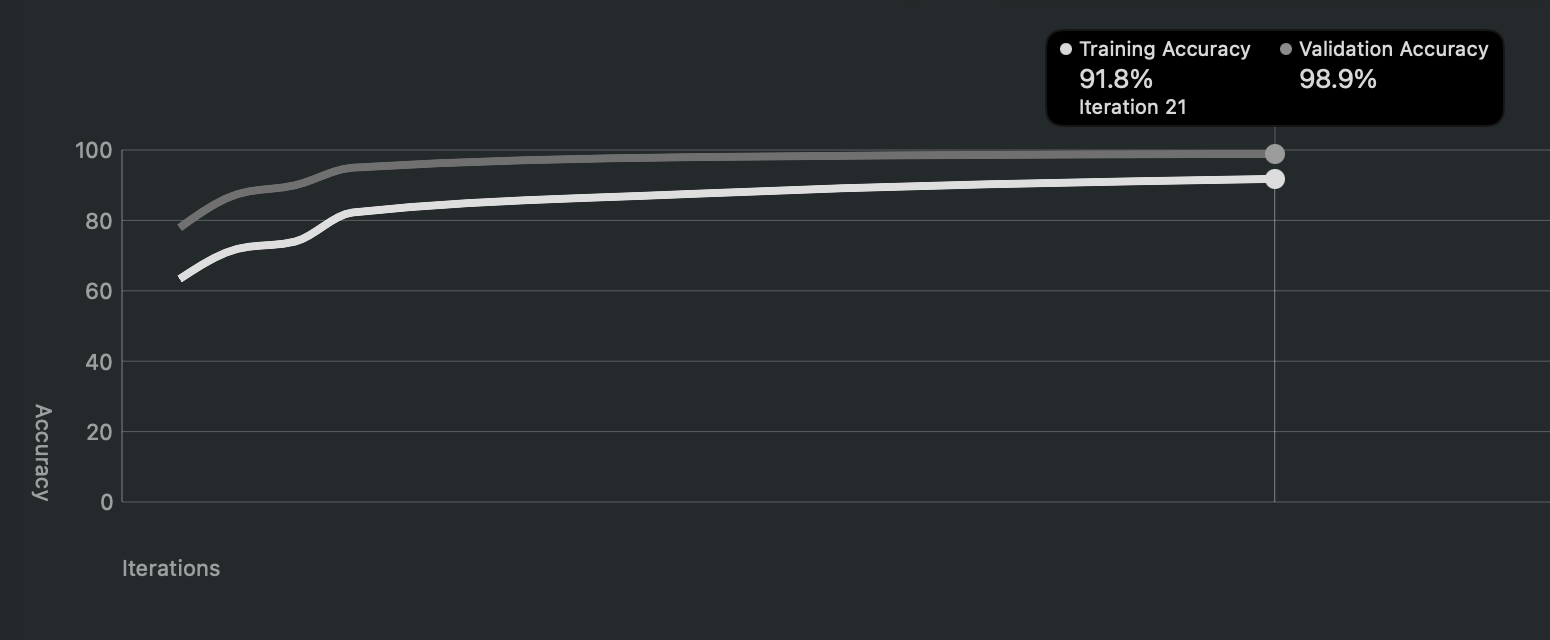
- 훈련 정확도(Training Accuracy) : 91.8%
→ 훈련 데이터셋 기반 학습률
- 검증 정확도(Validation Accuracy) : 98.9%
→ 훈련되지 않은 검증 데이터셋에서의 일반화 비율
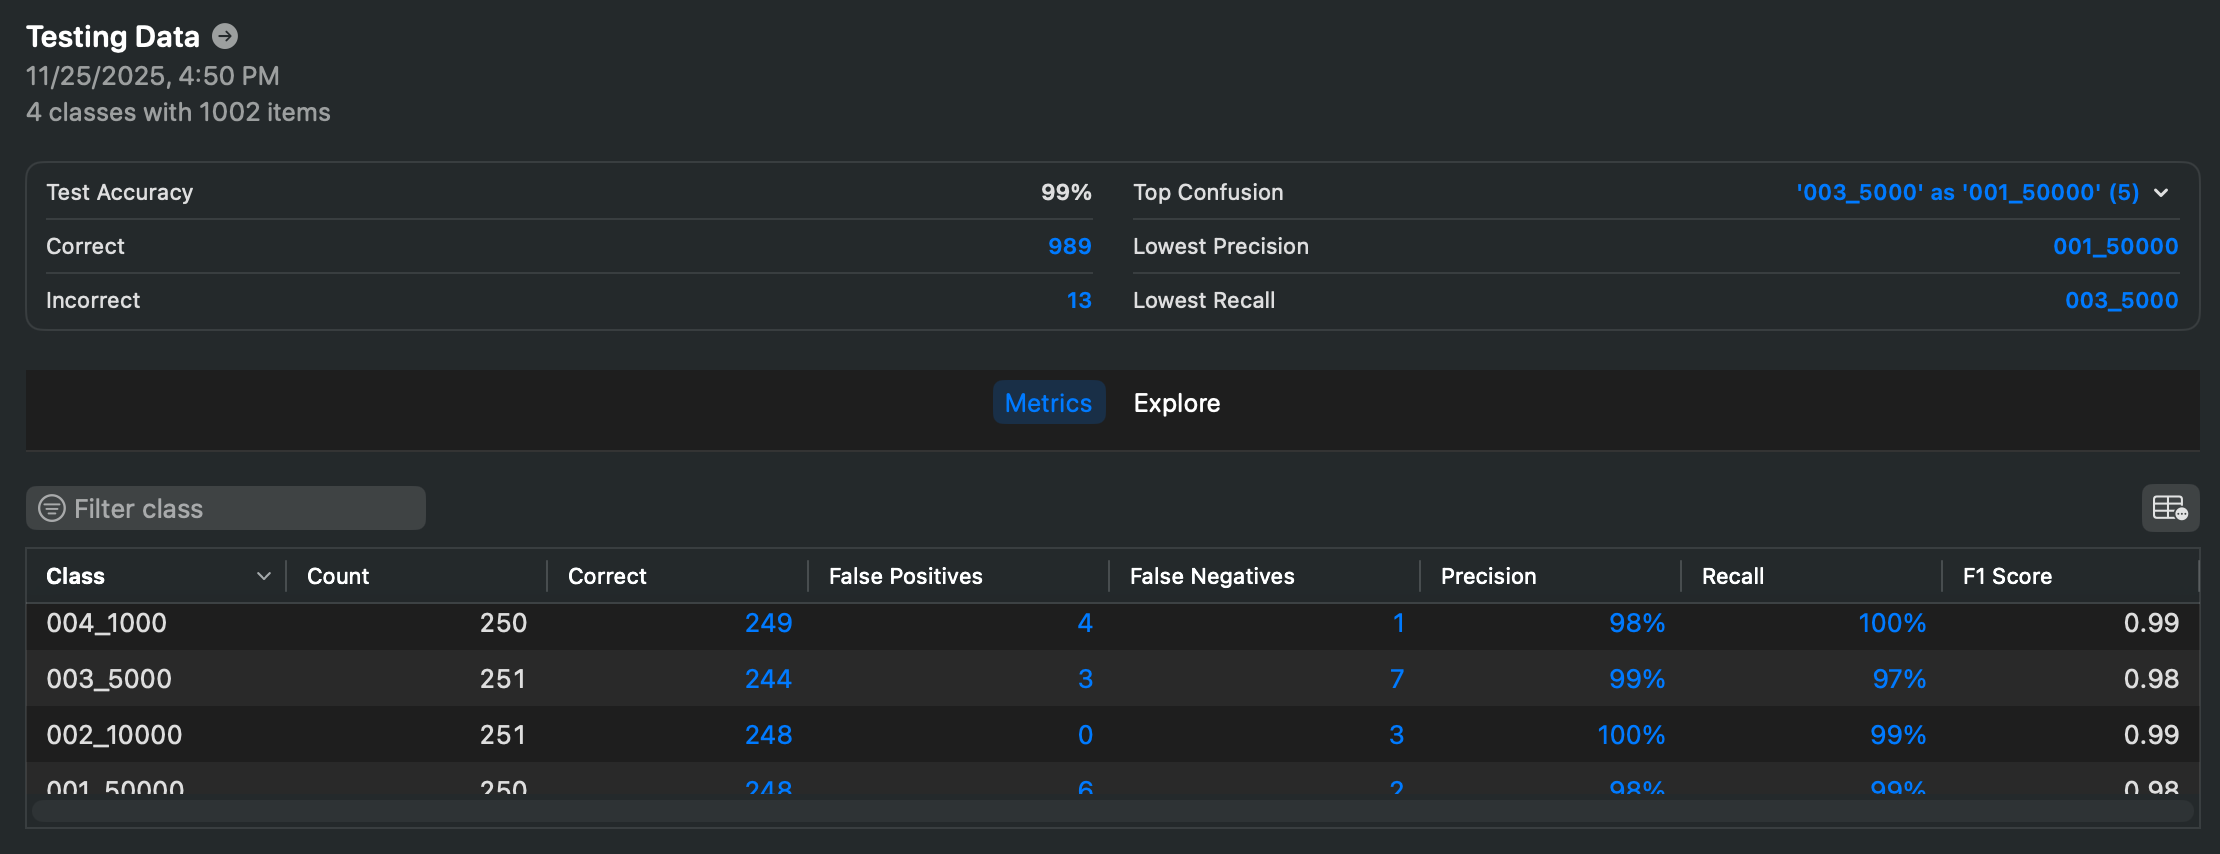
- 테스트 결과(테스트 셋으로 테스트 진행, 약 1000장)
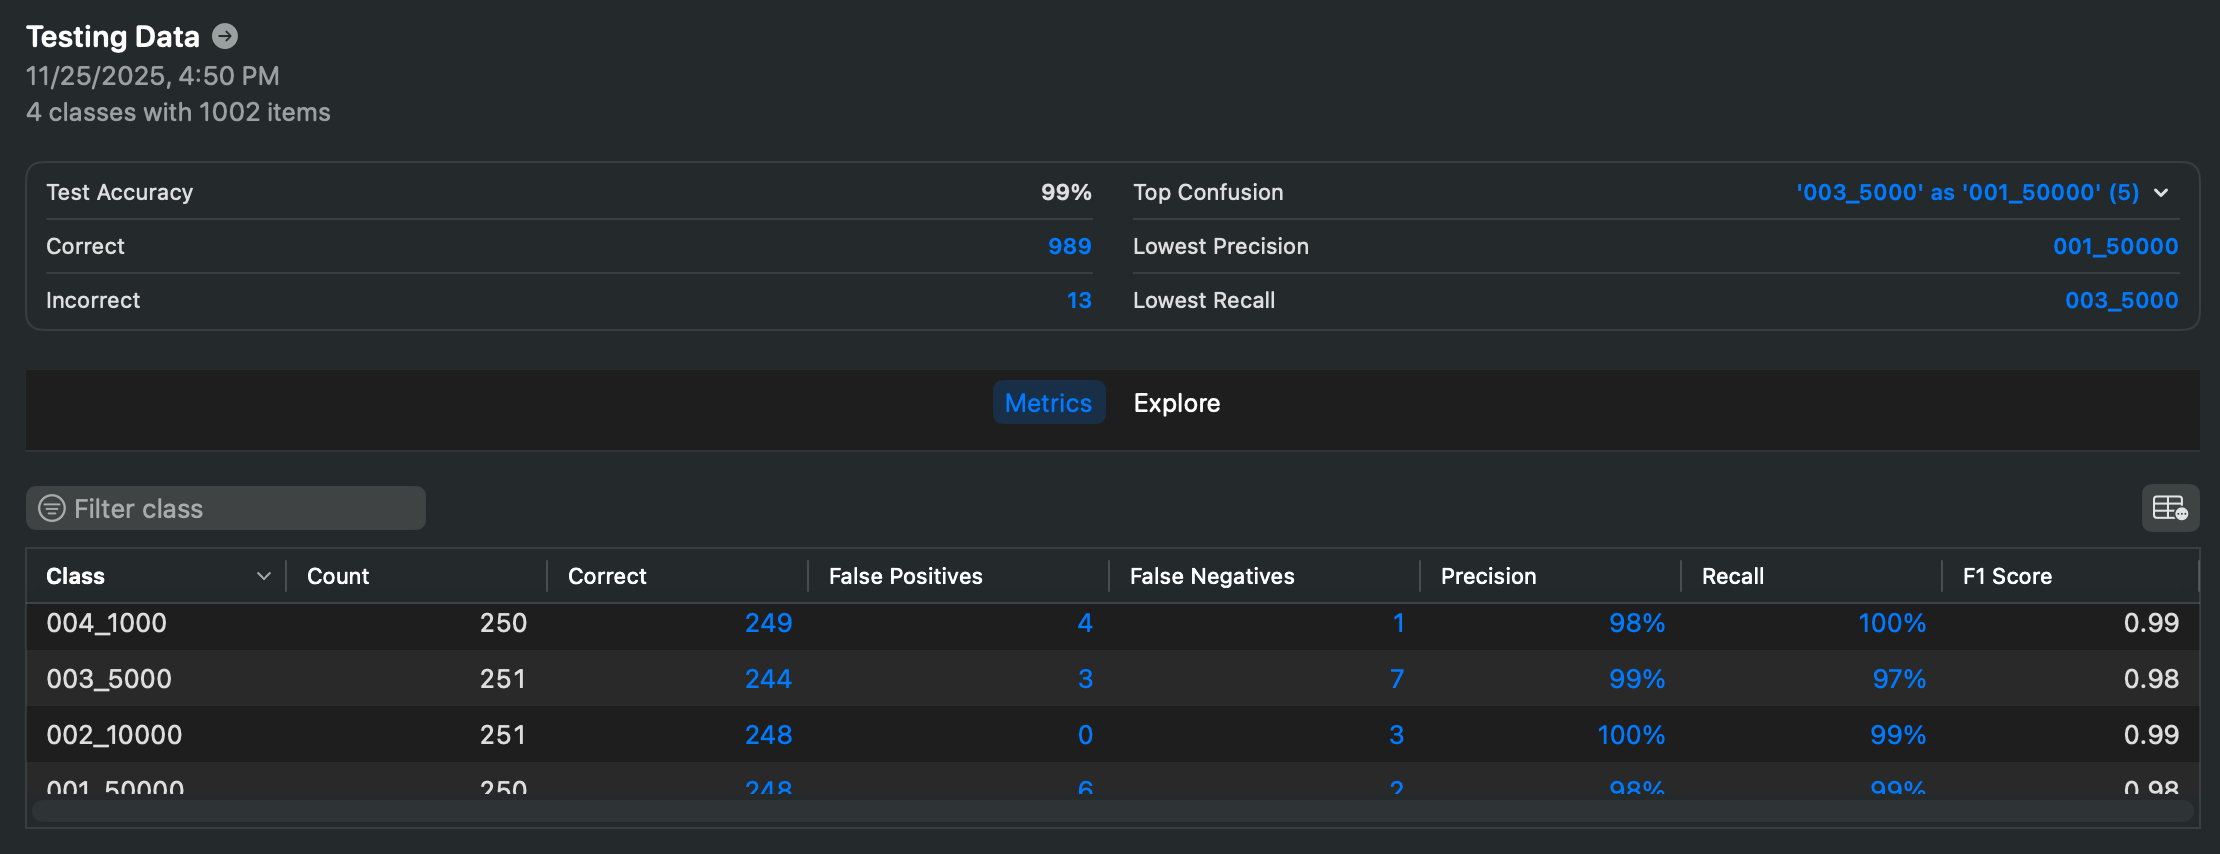
- 테스트 결과(기타 데이터셋 약 700장)
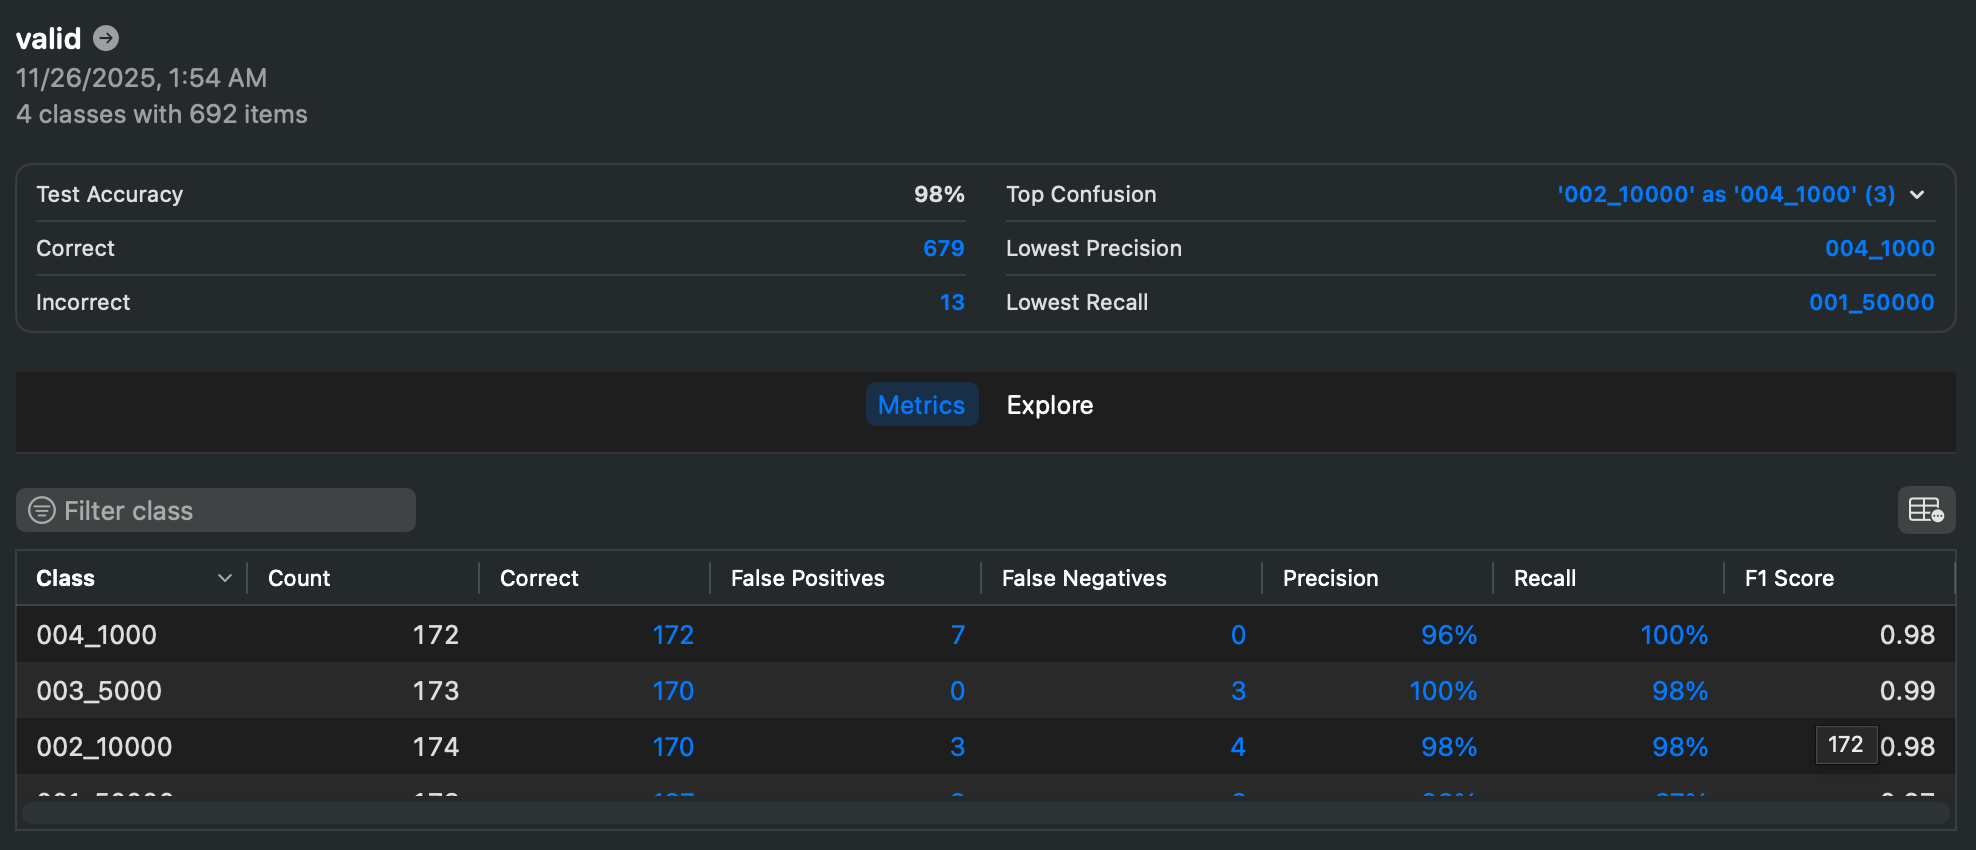
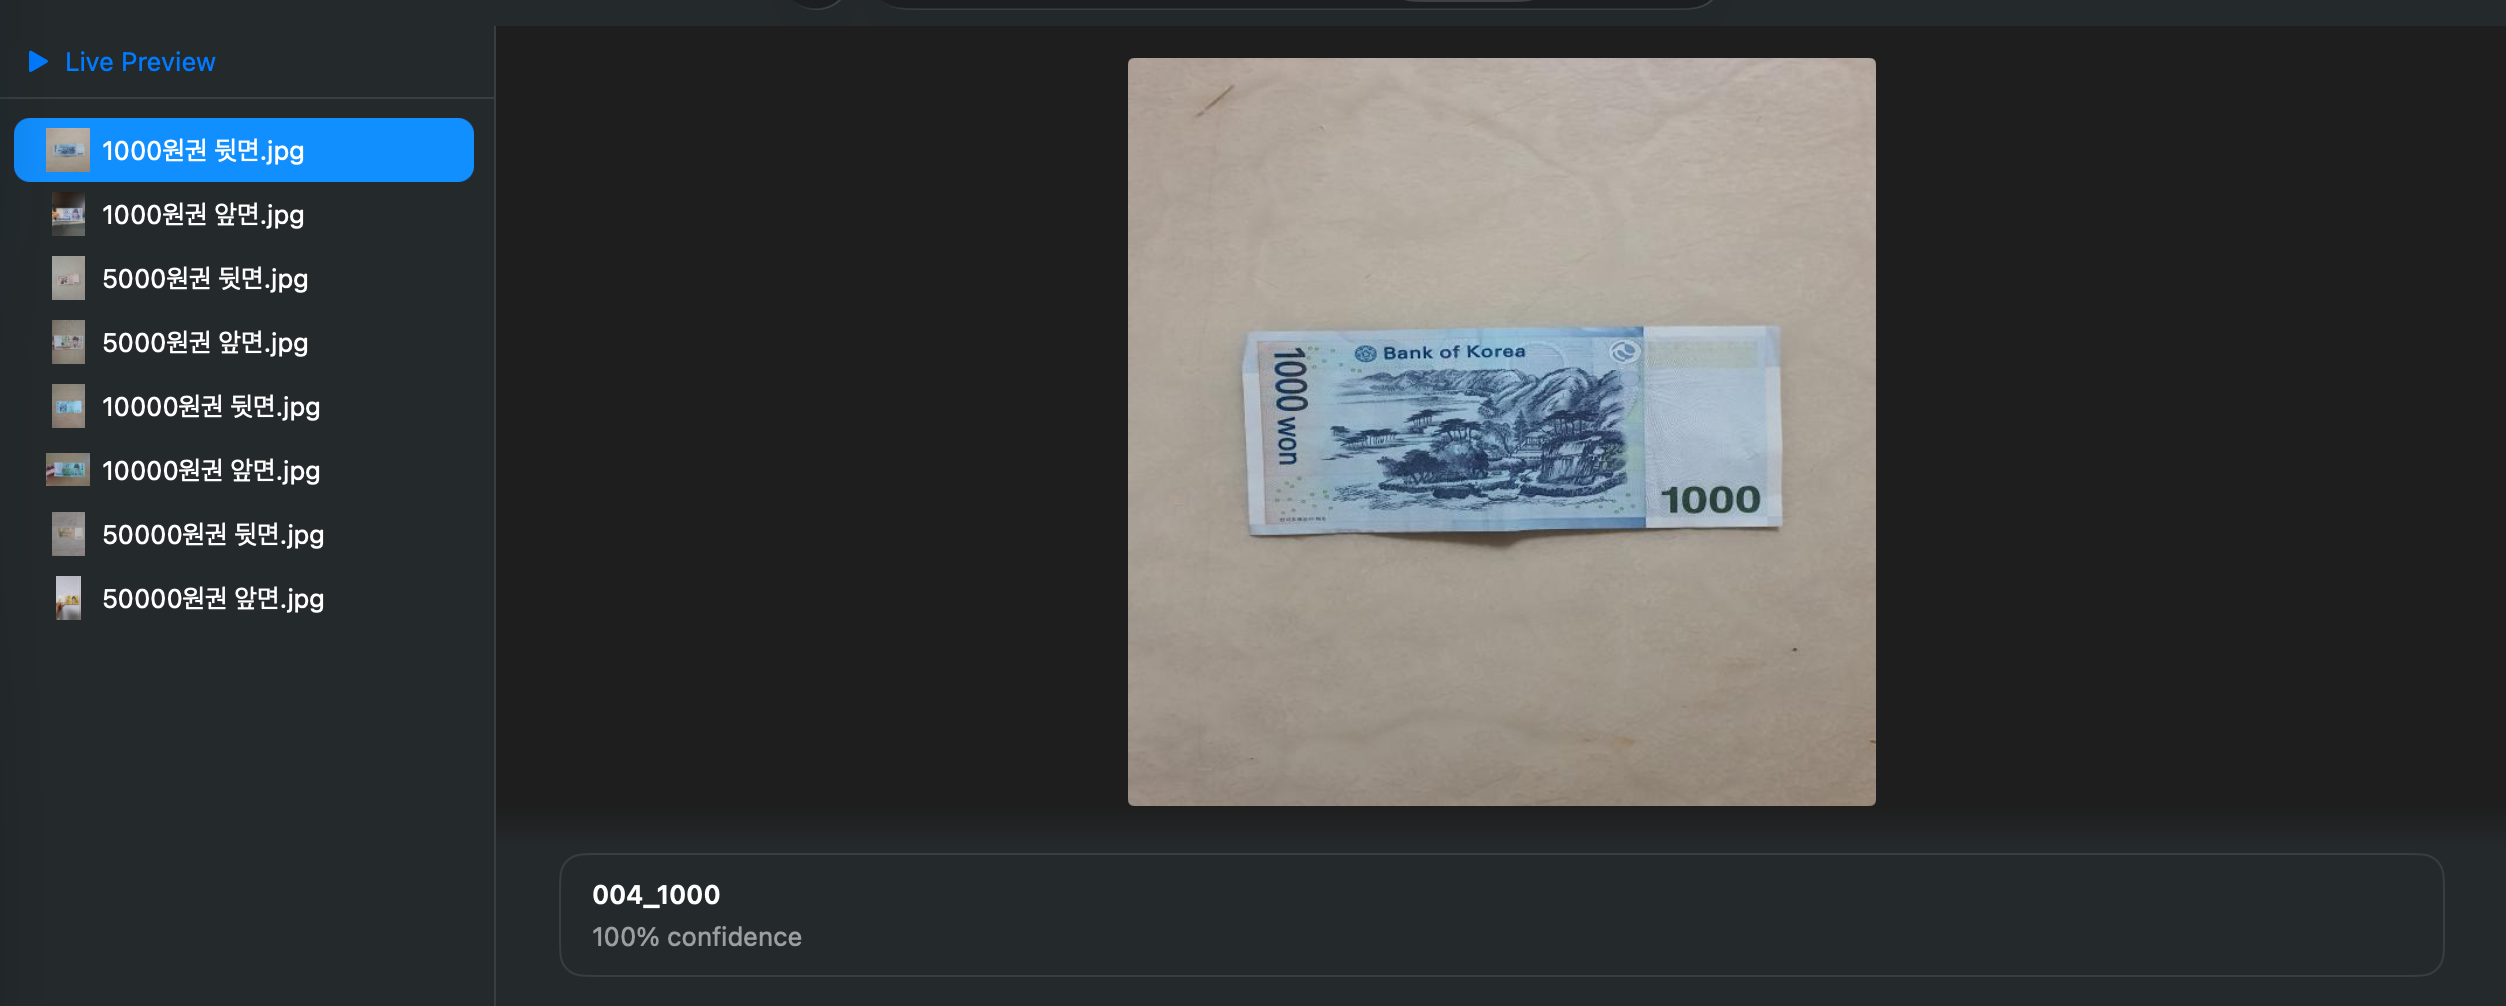
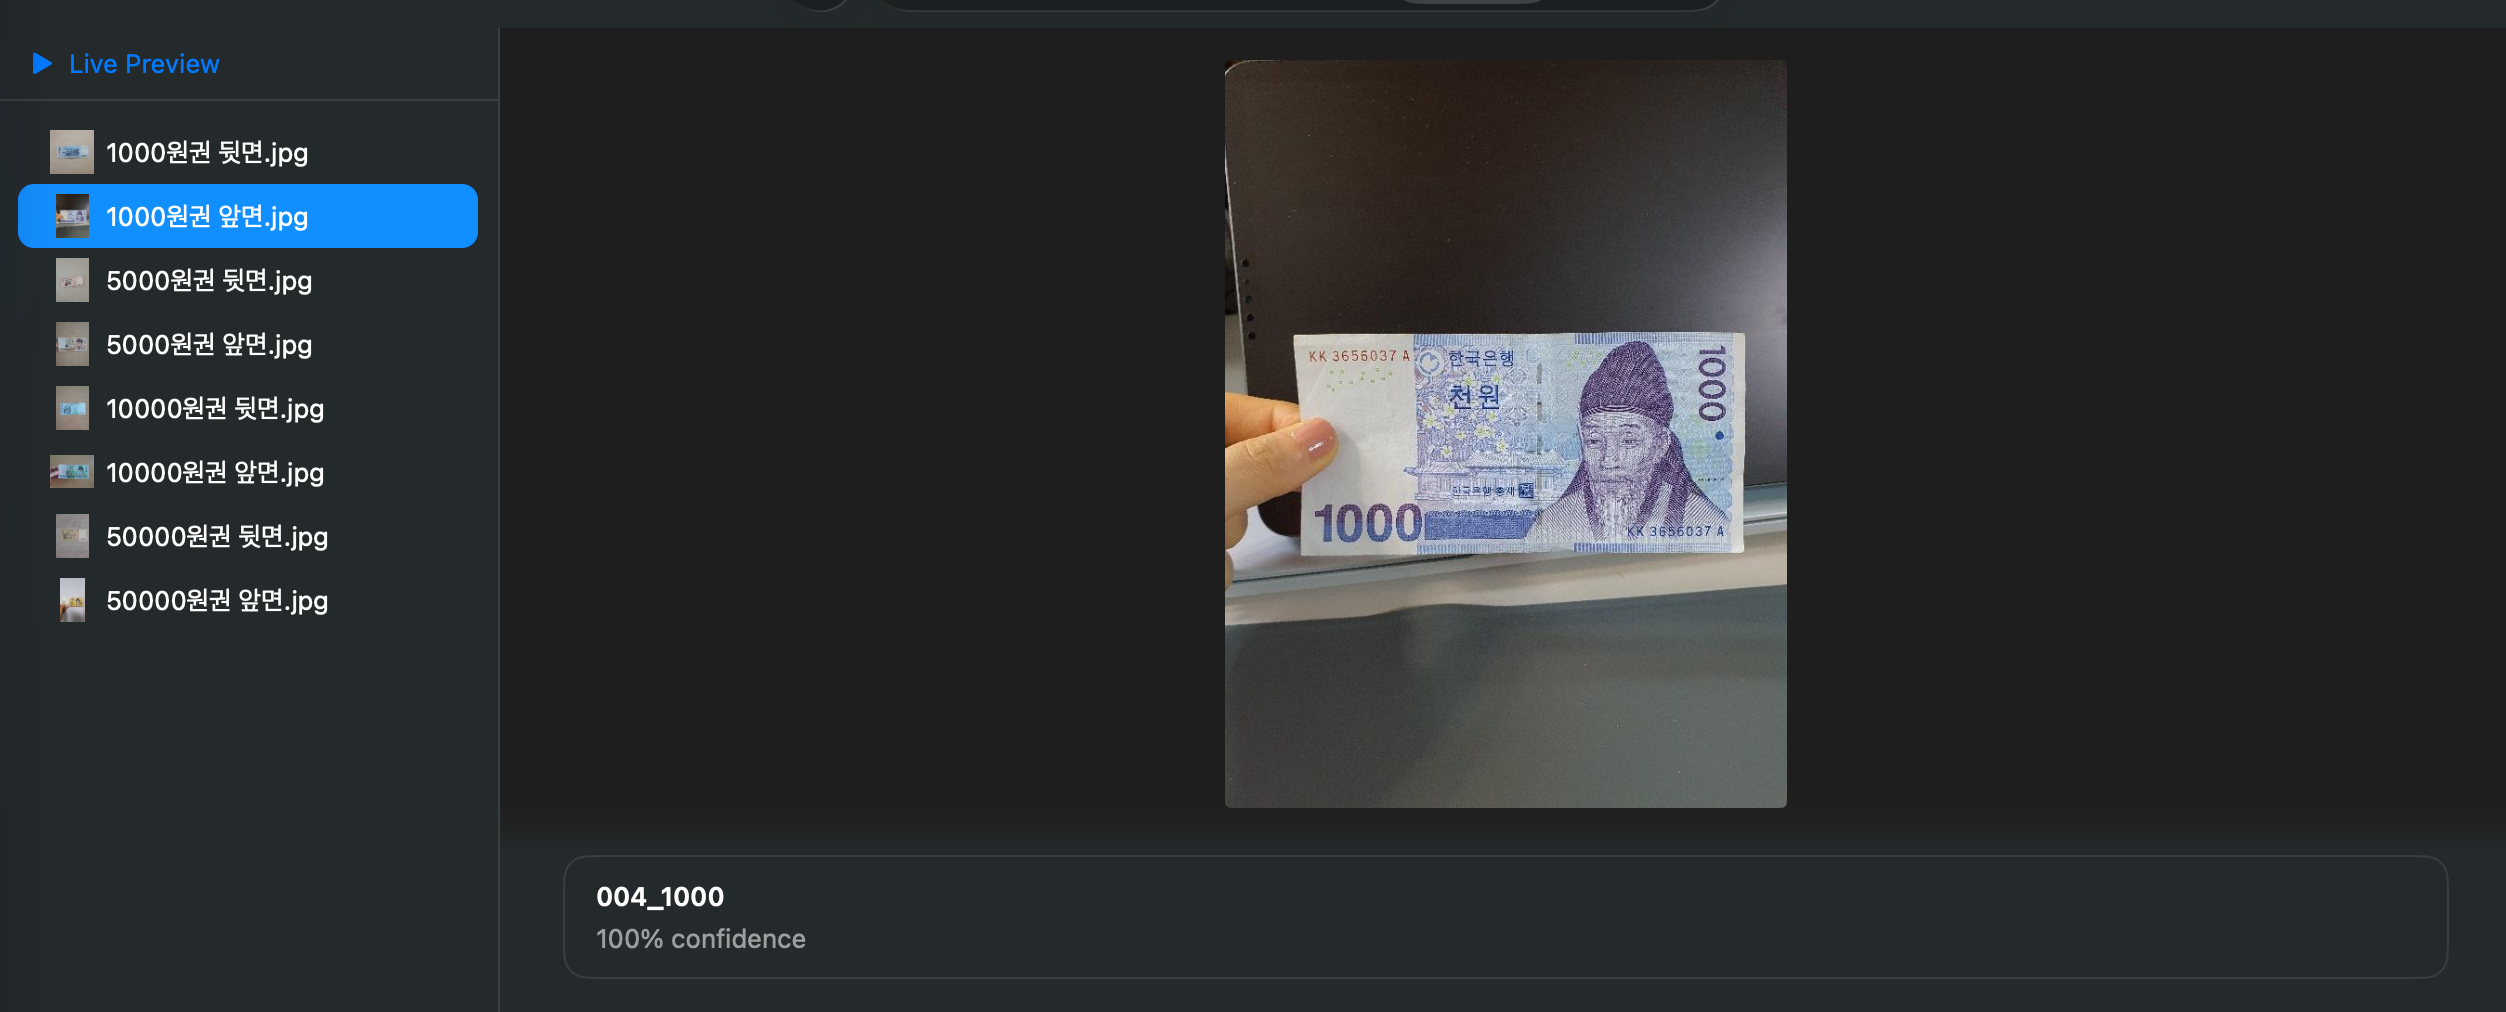
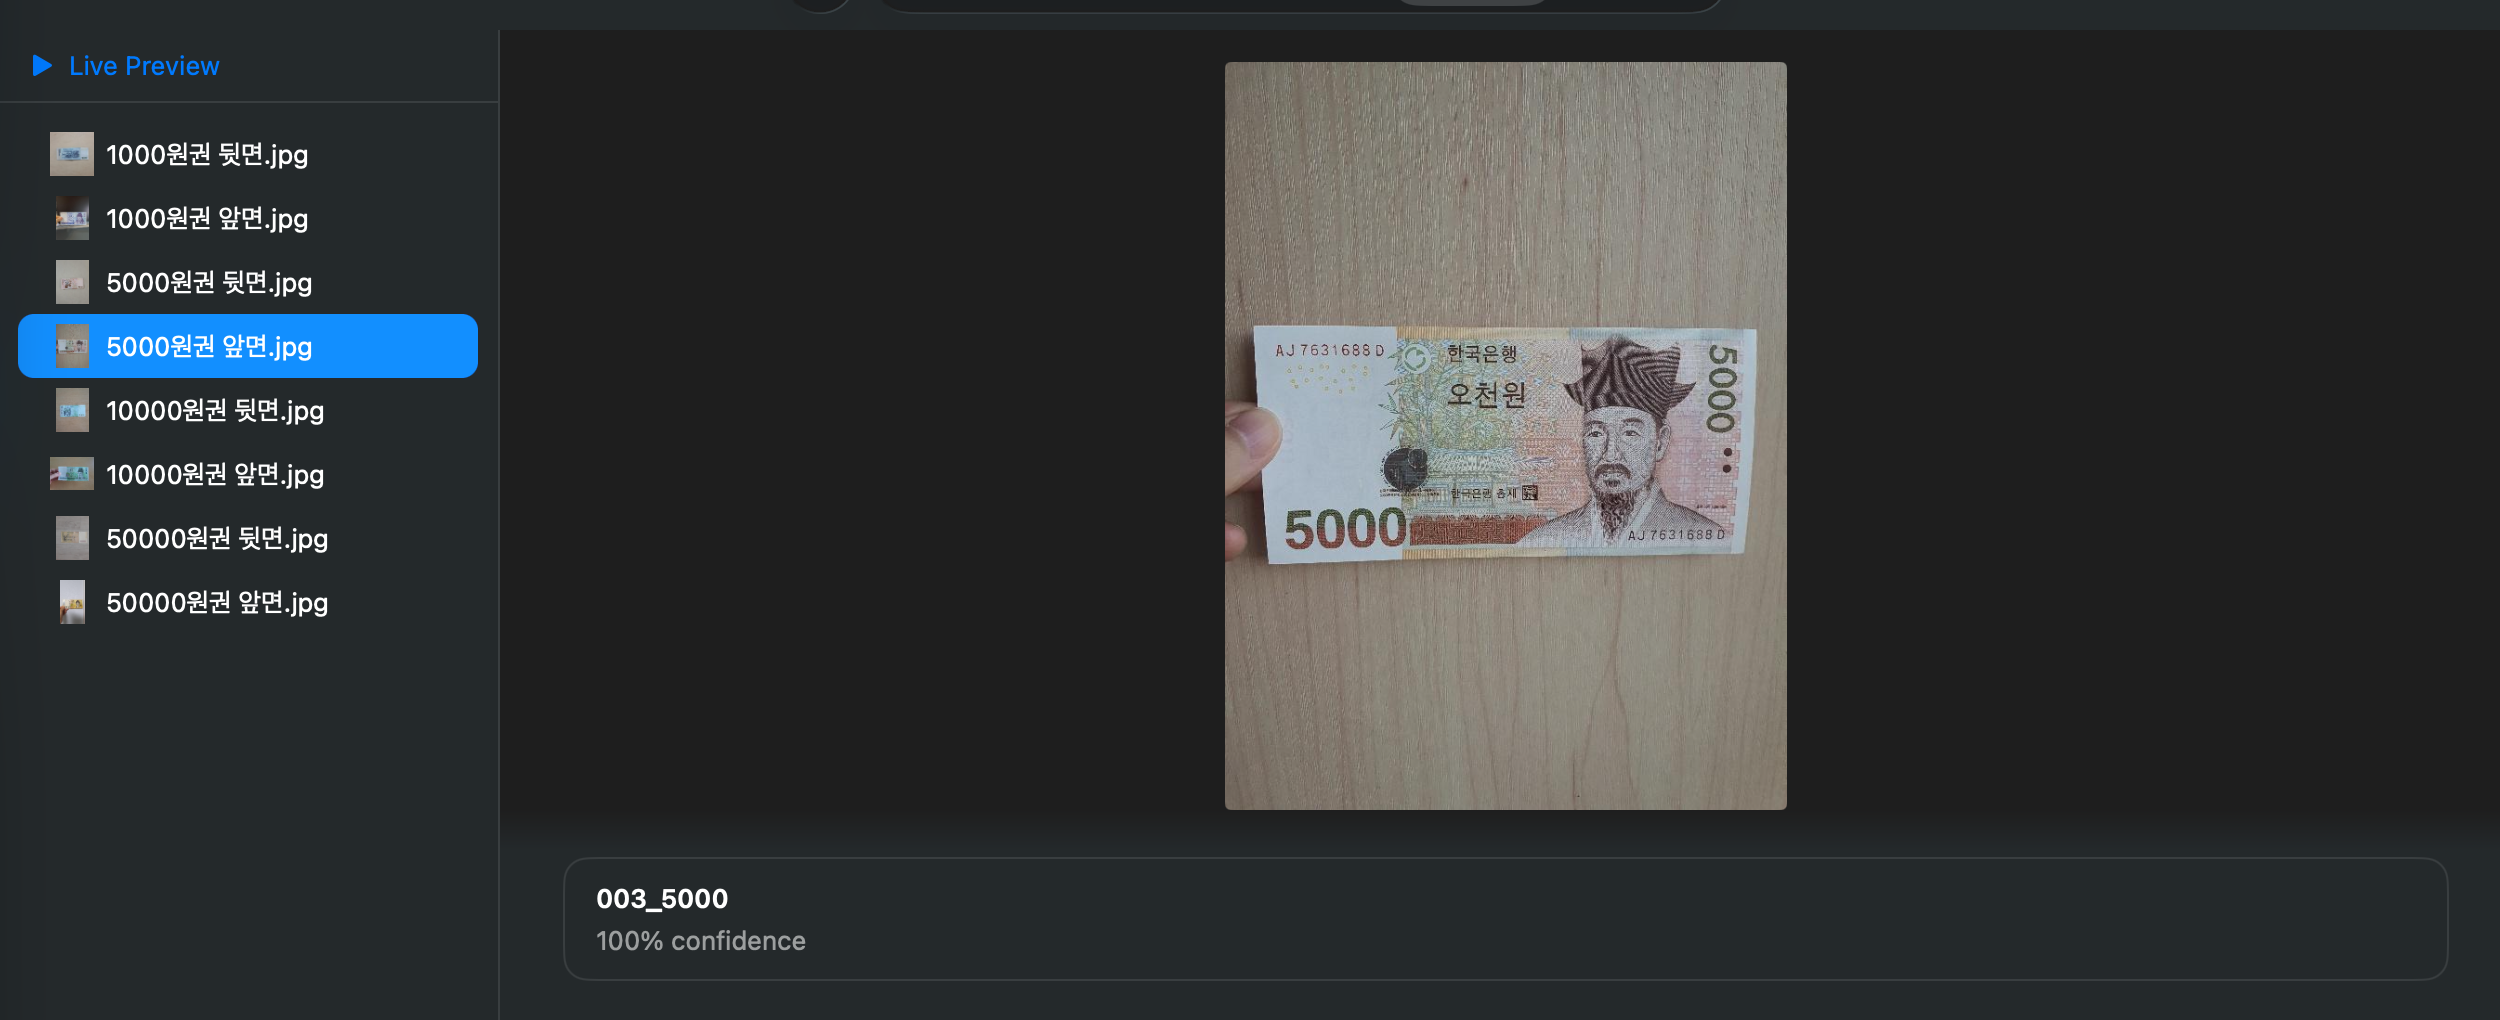
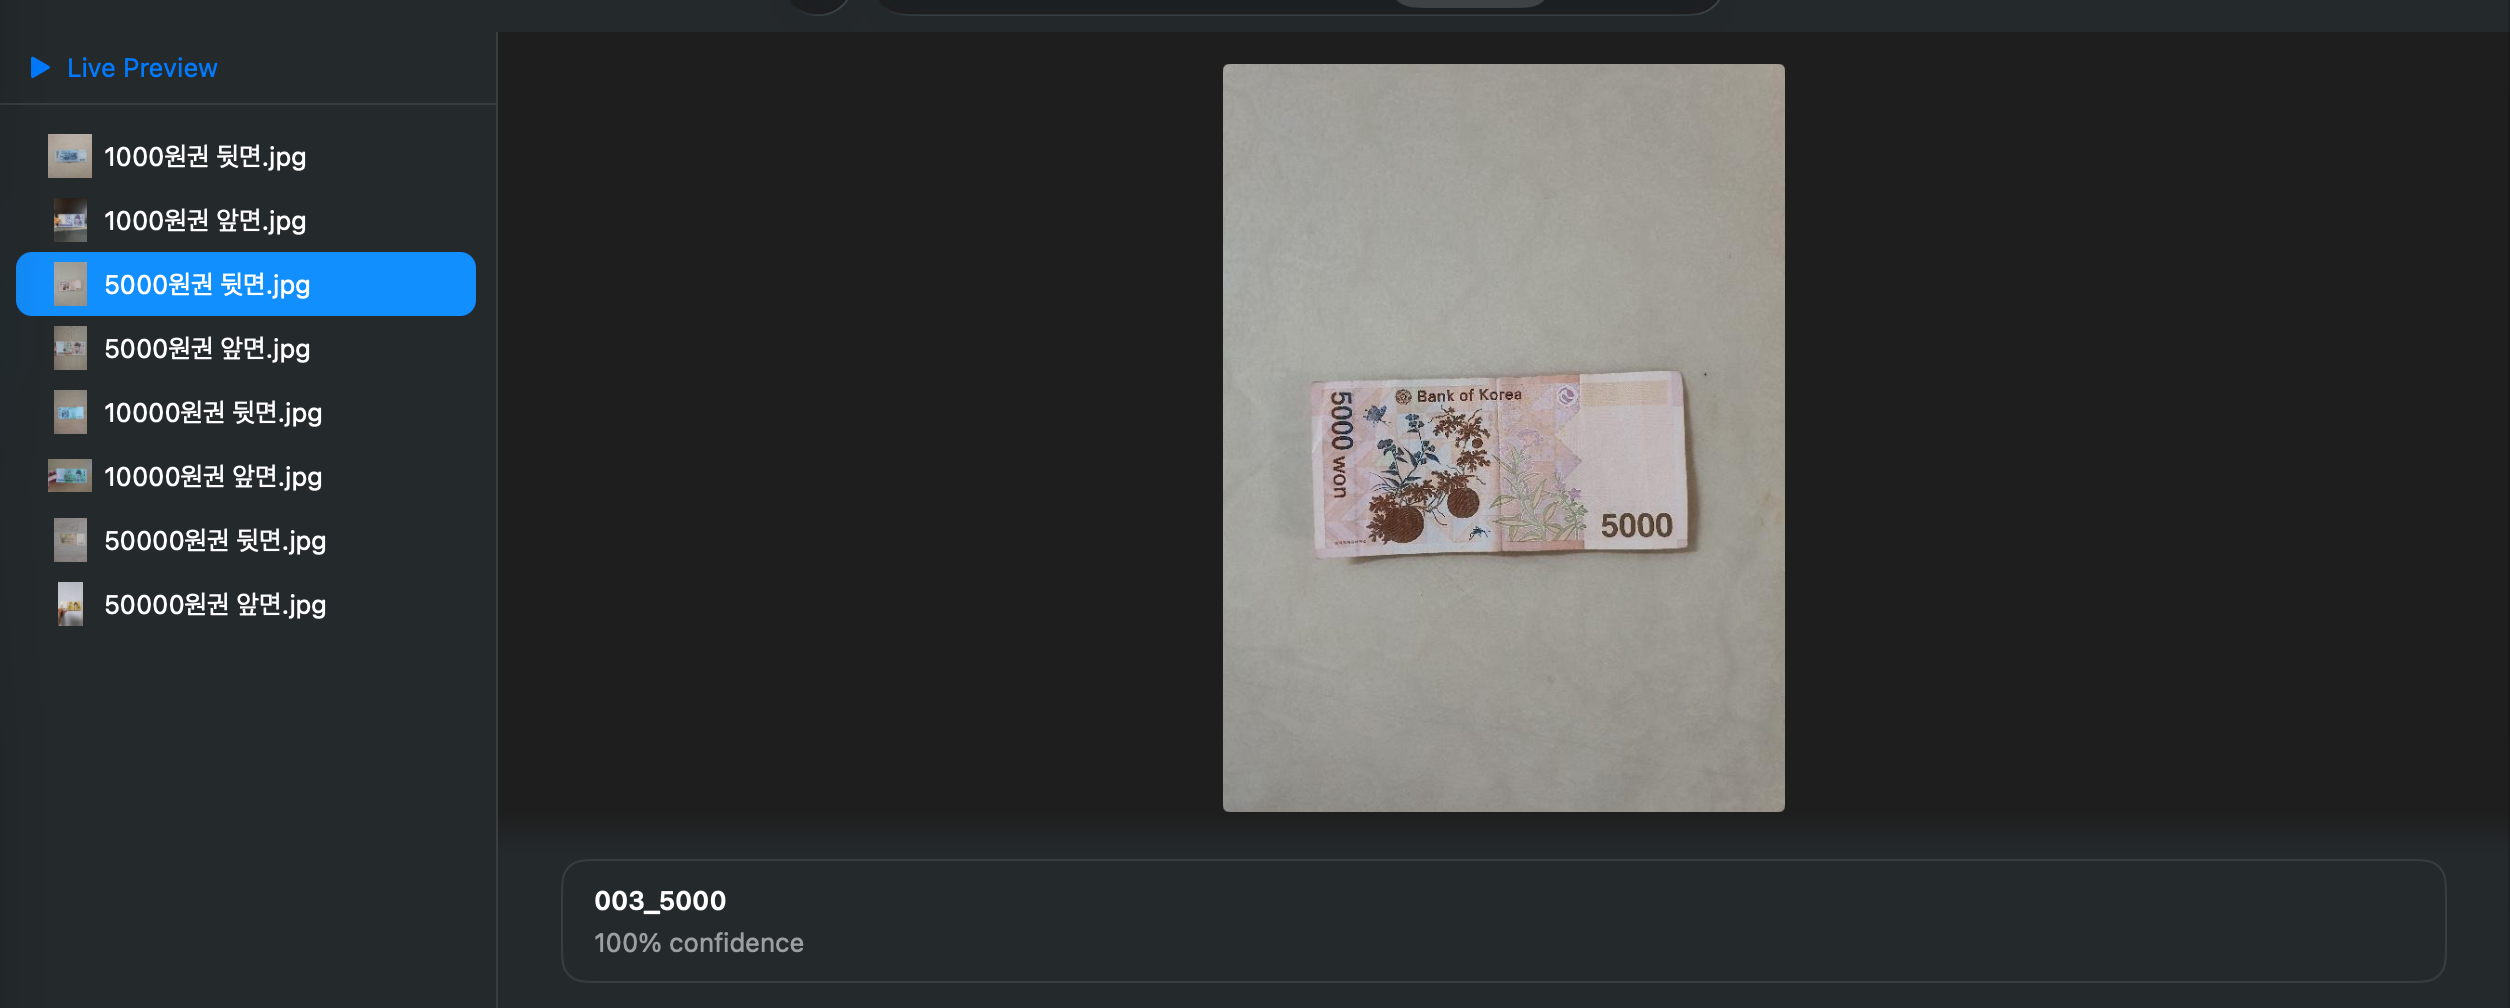
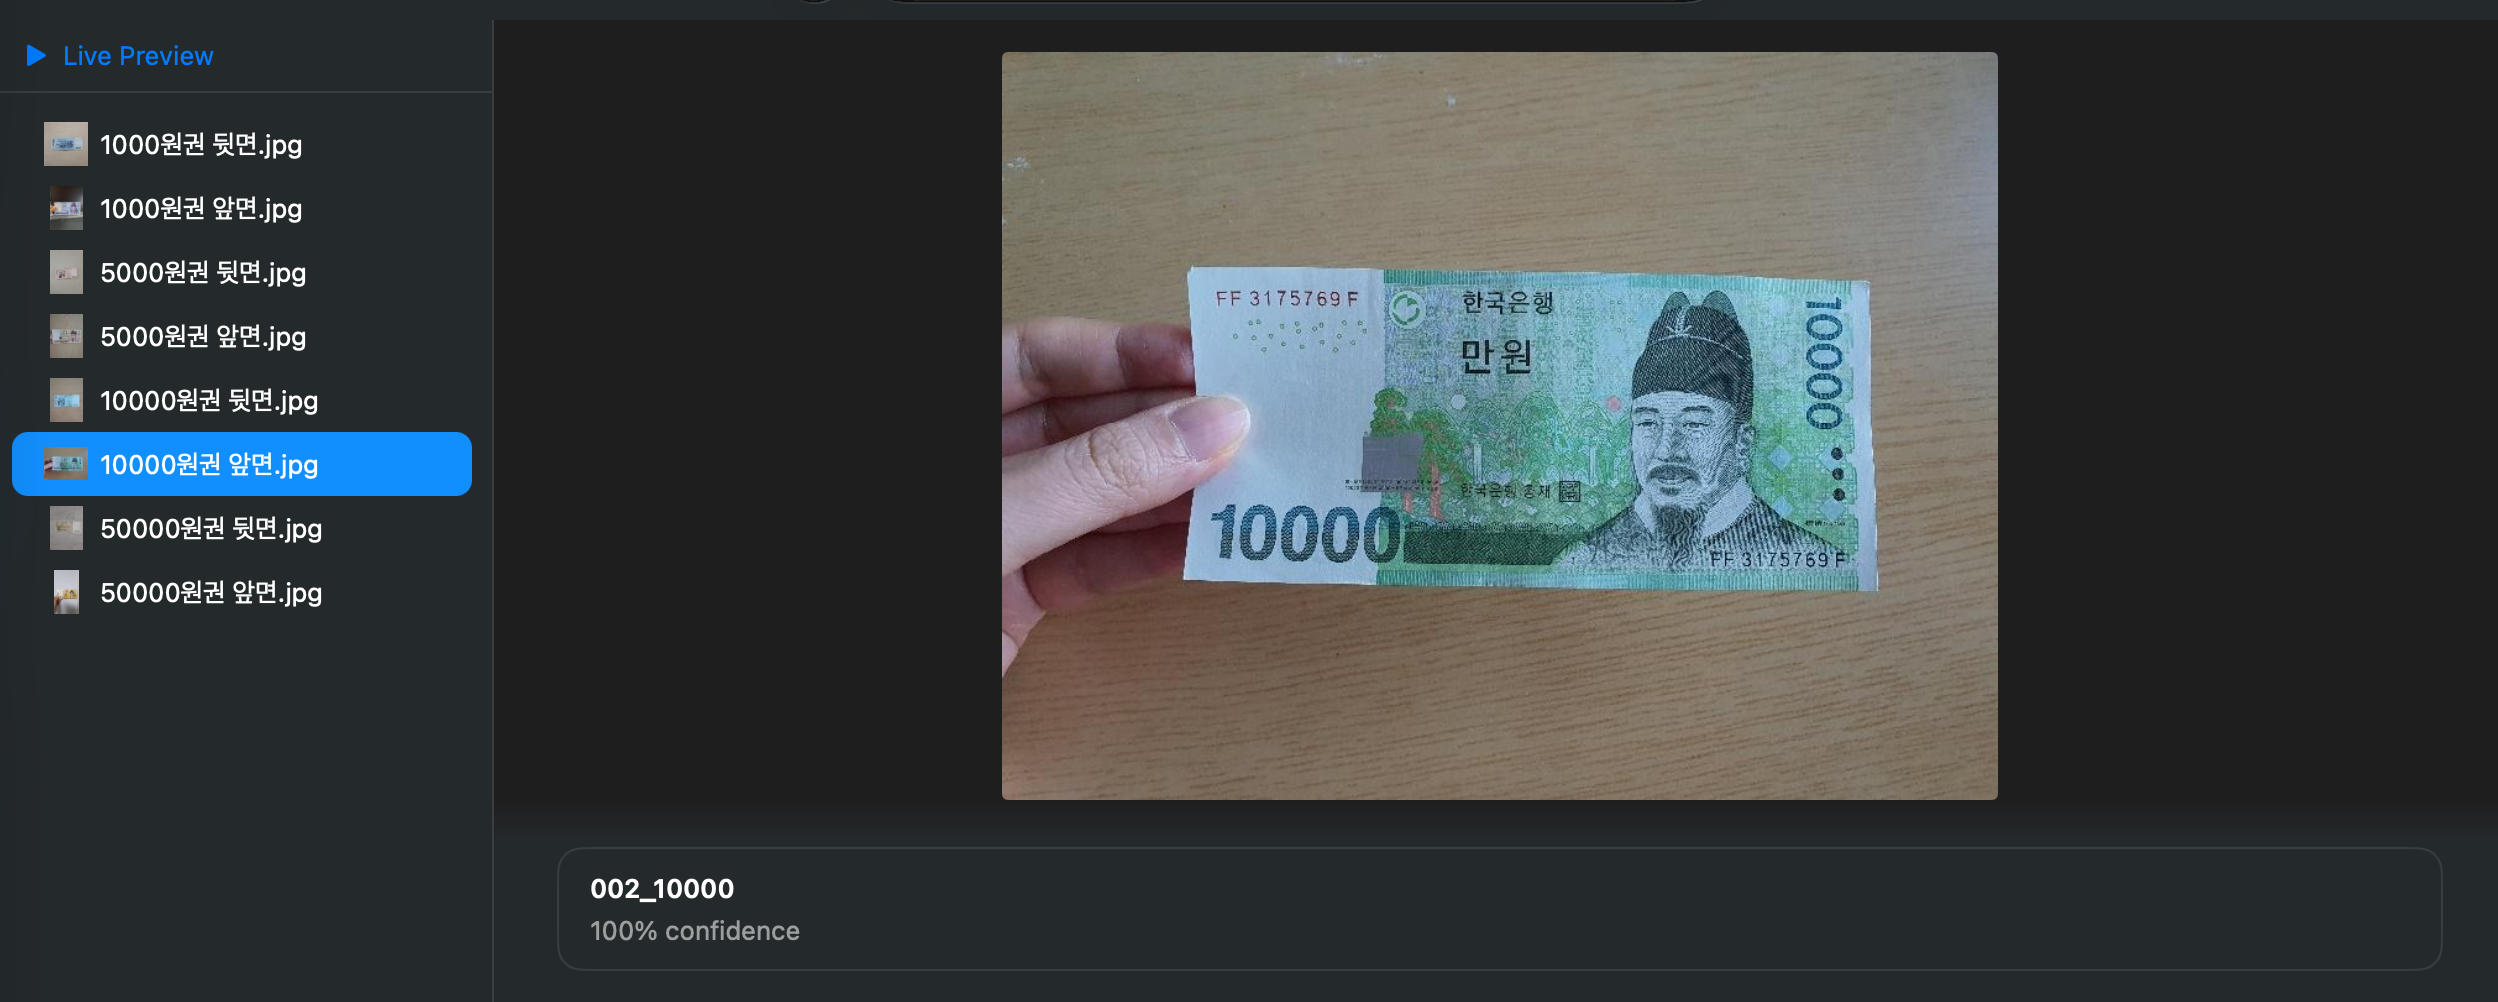
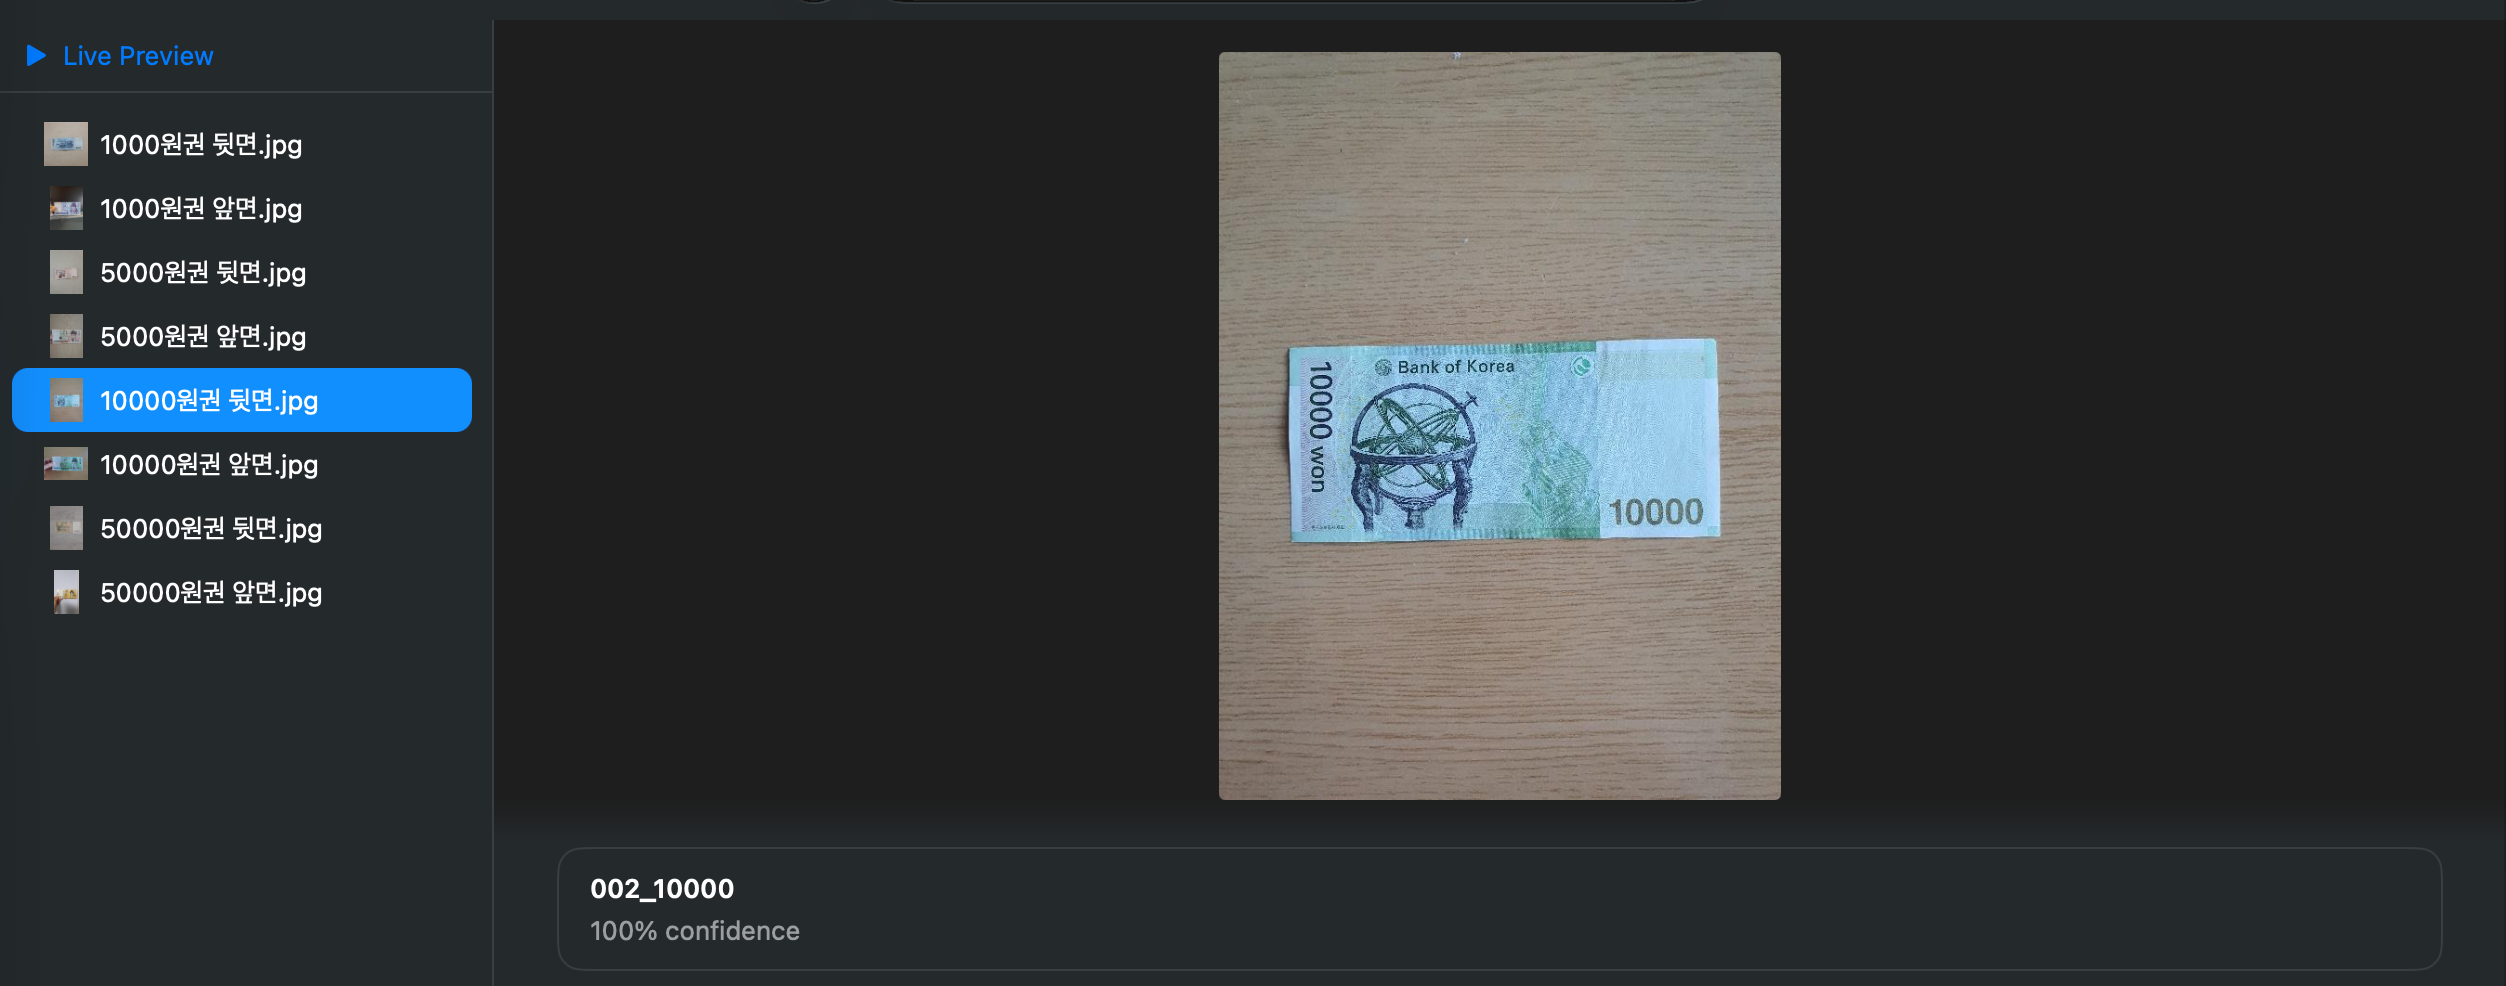
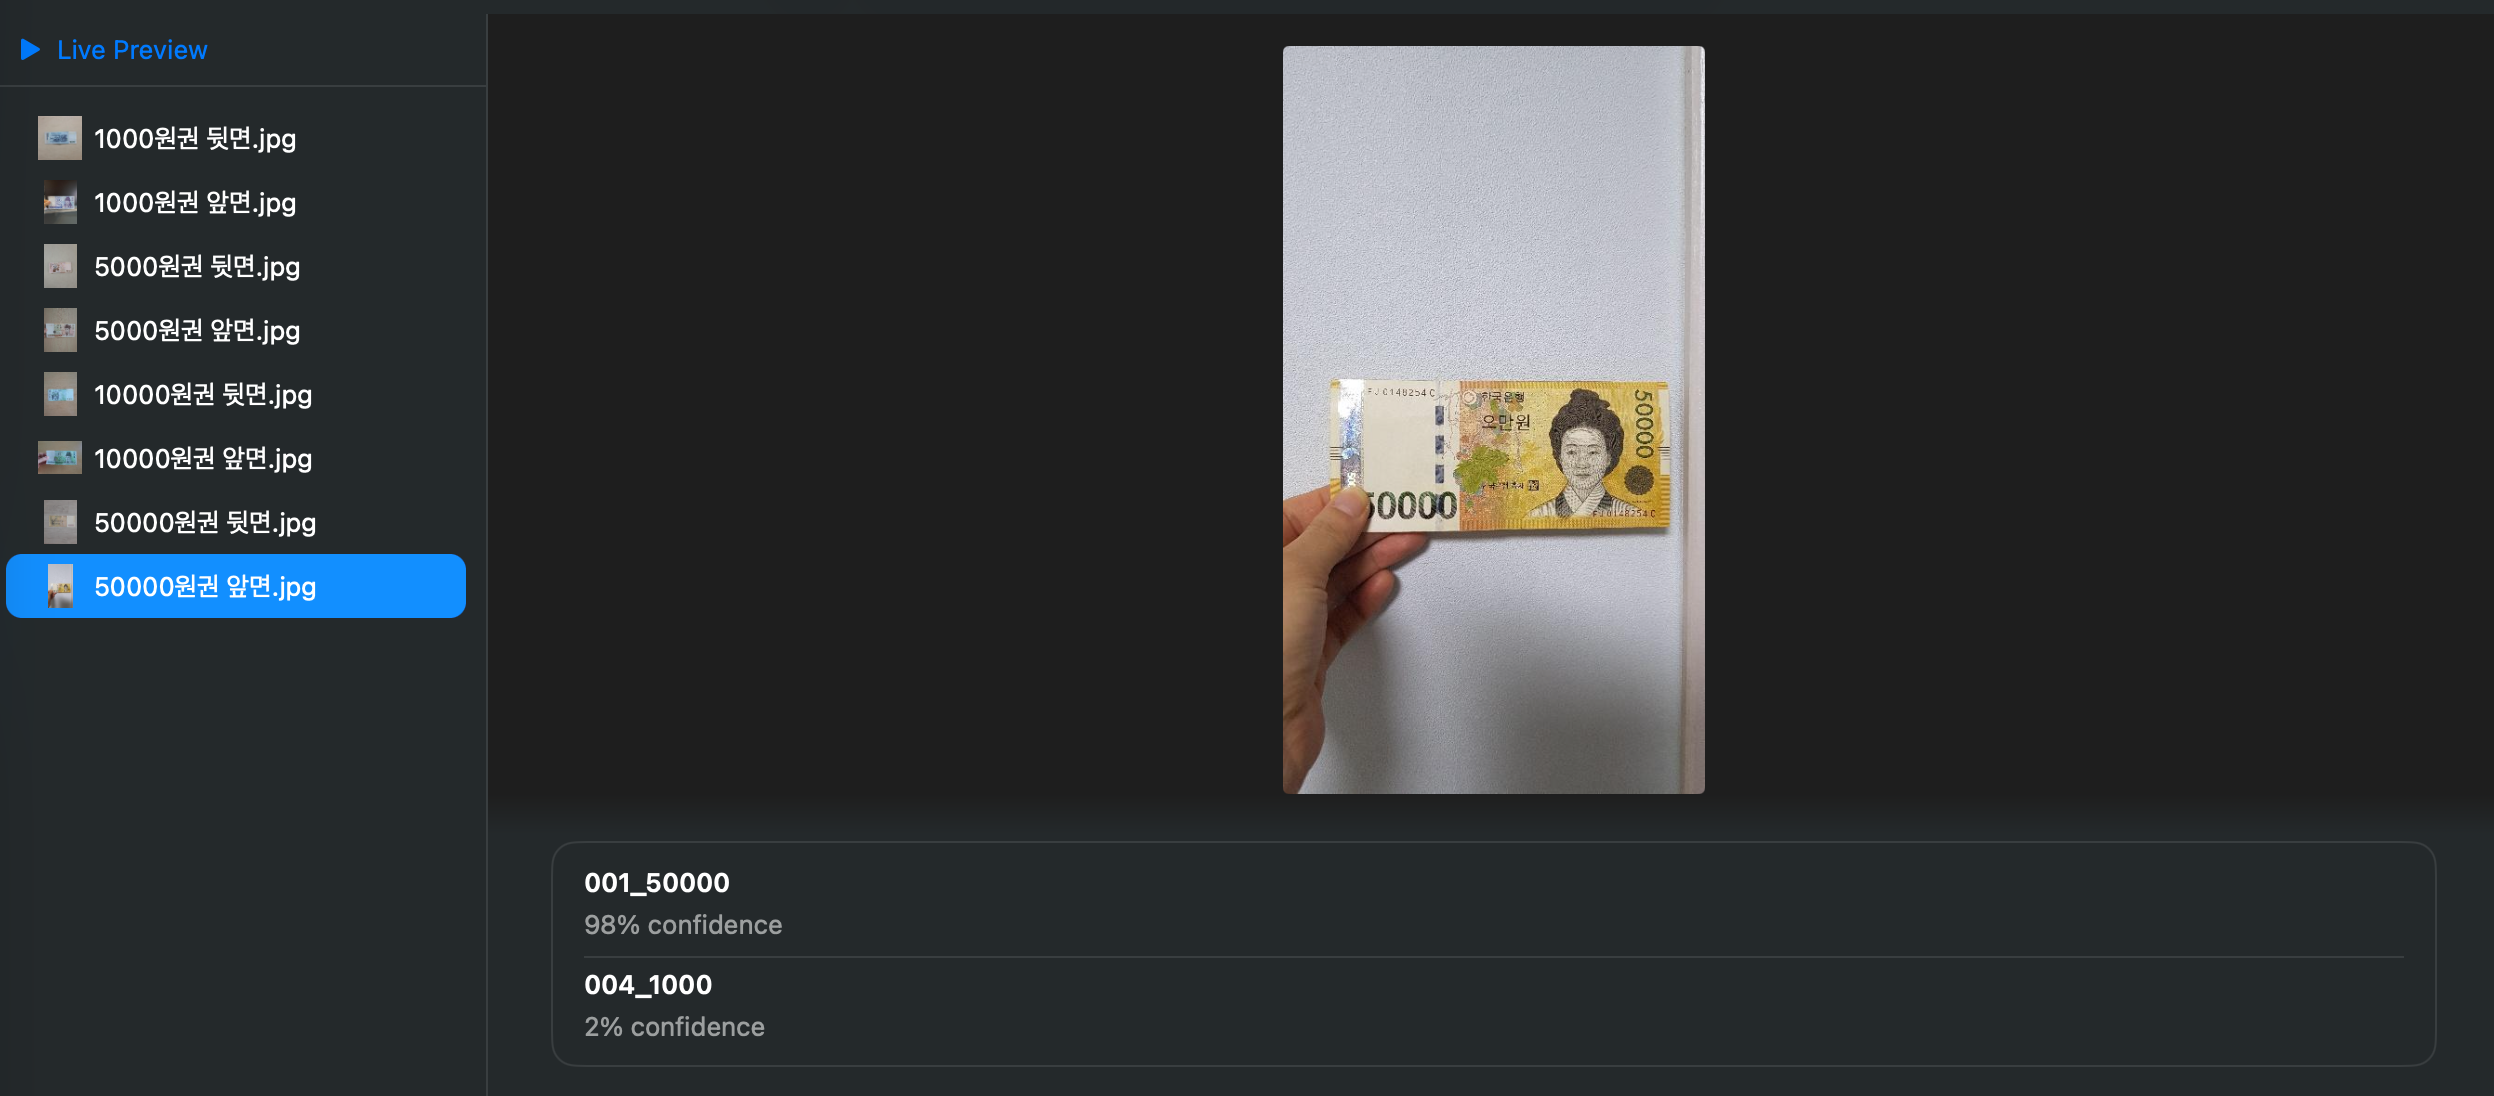
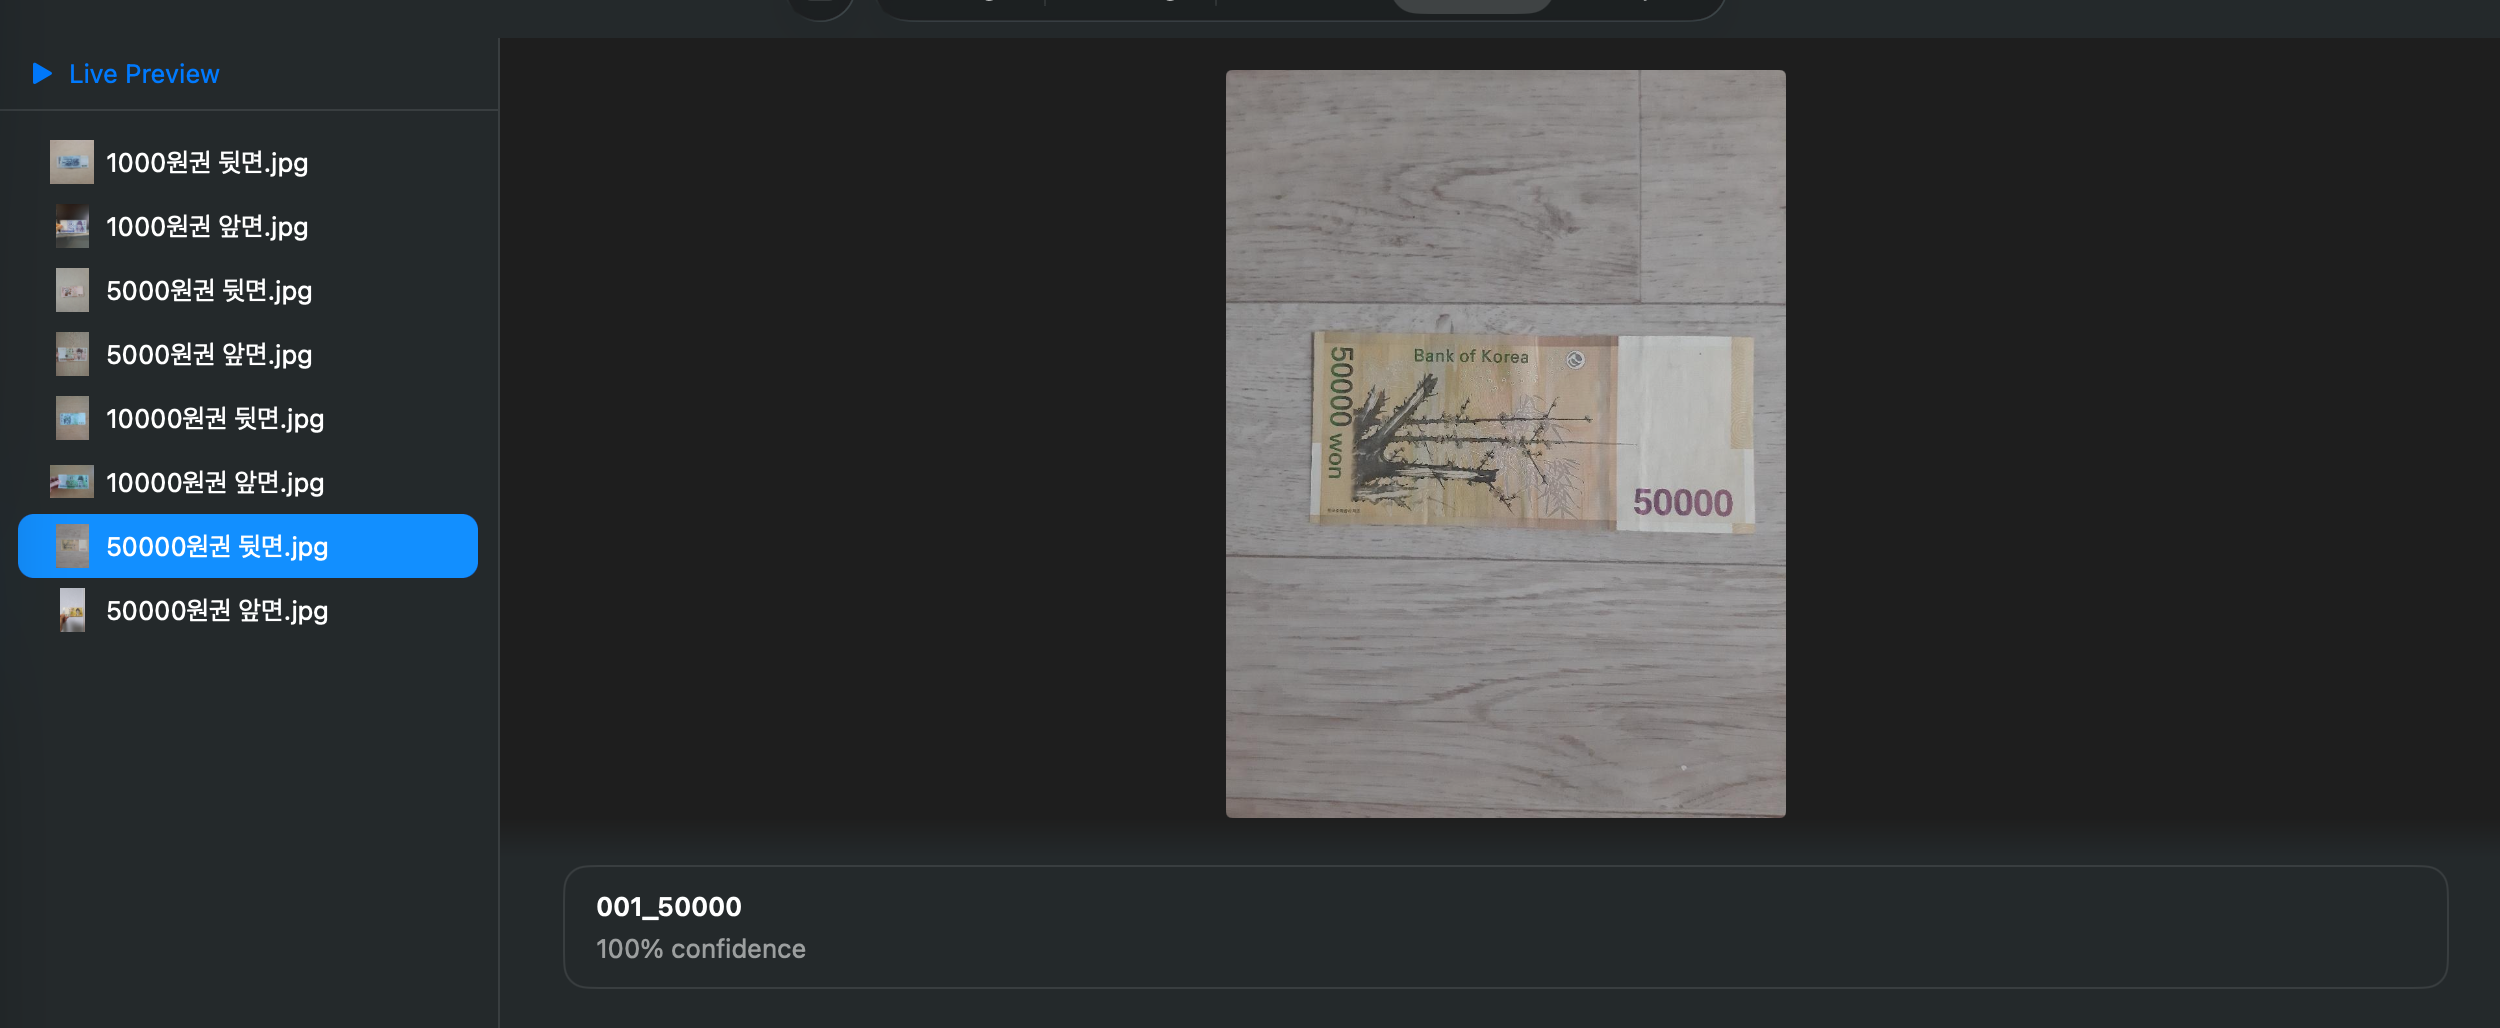
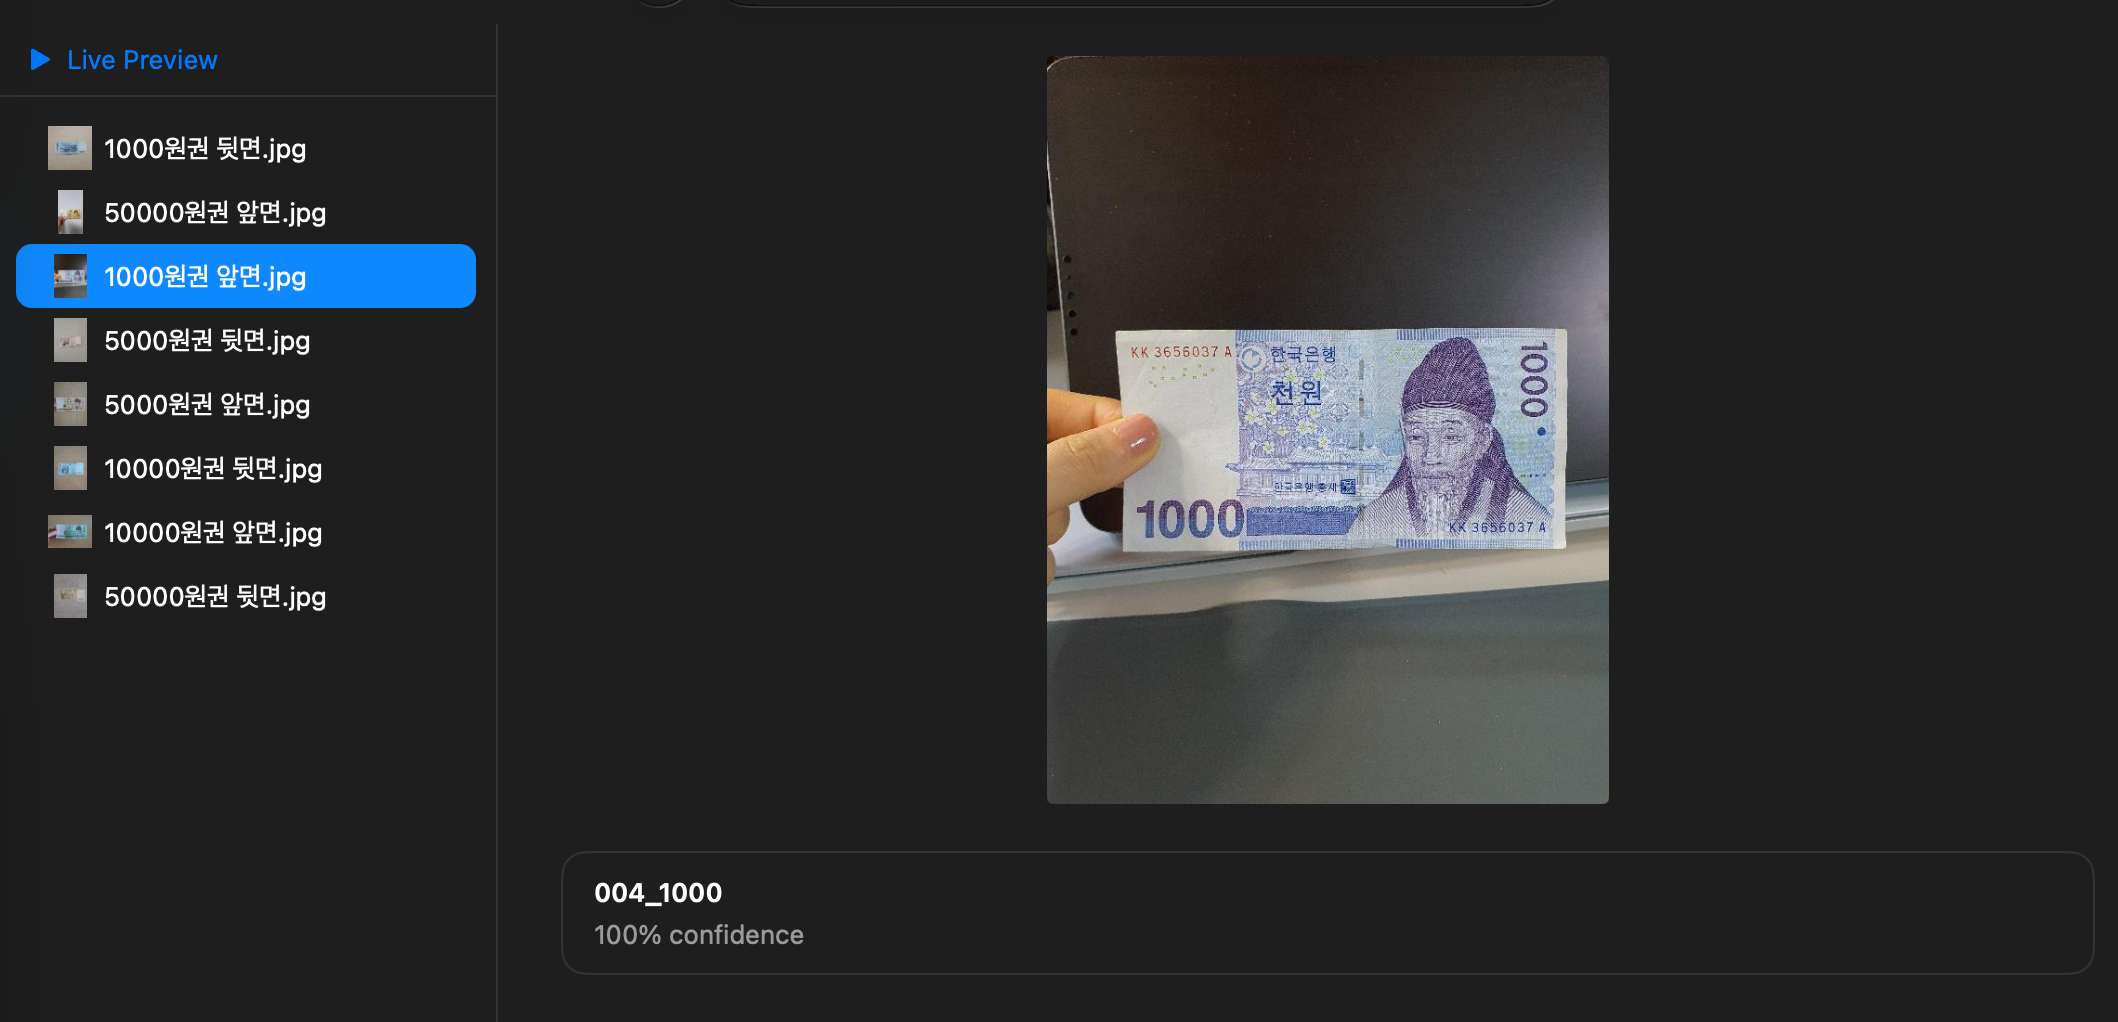
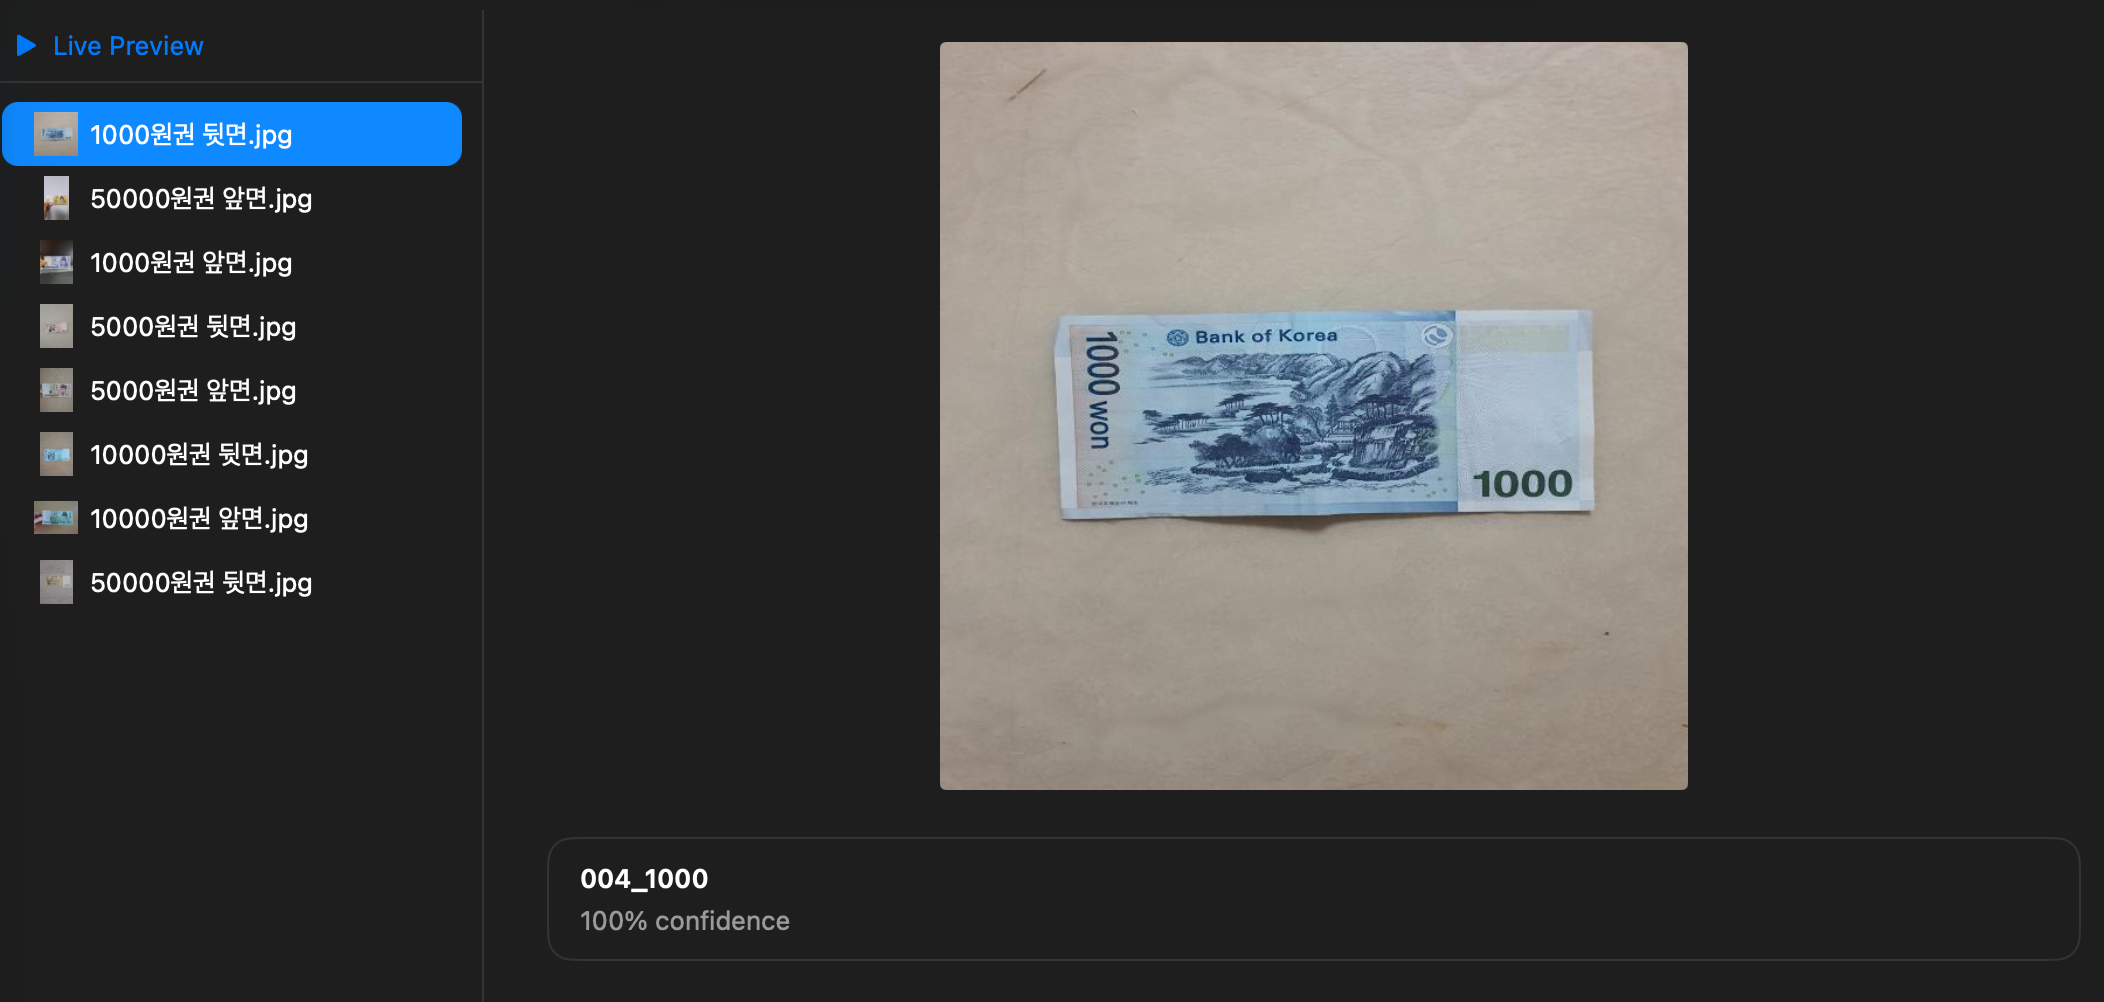
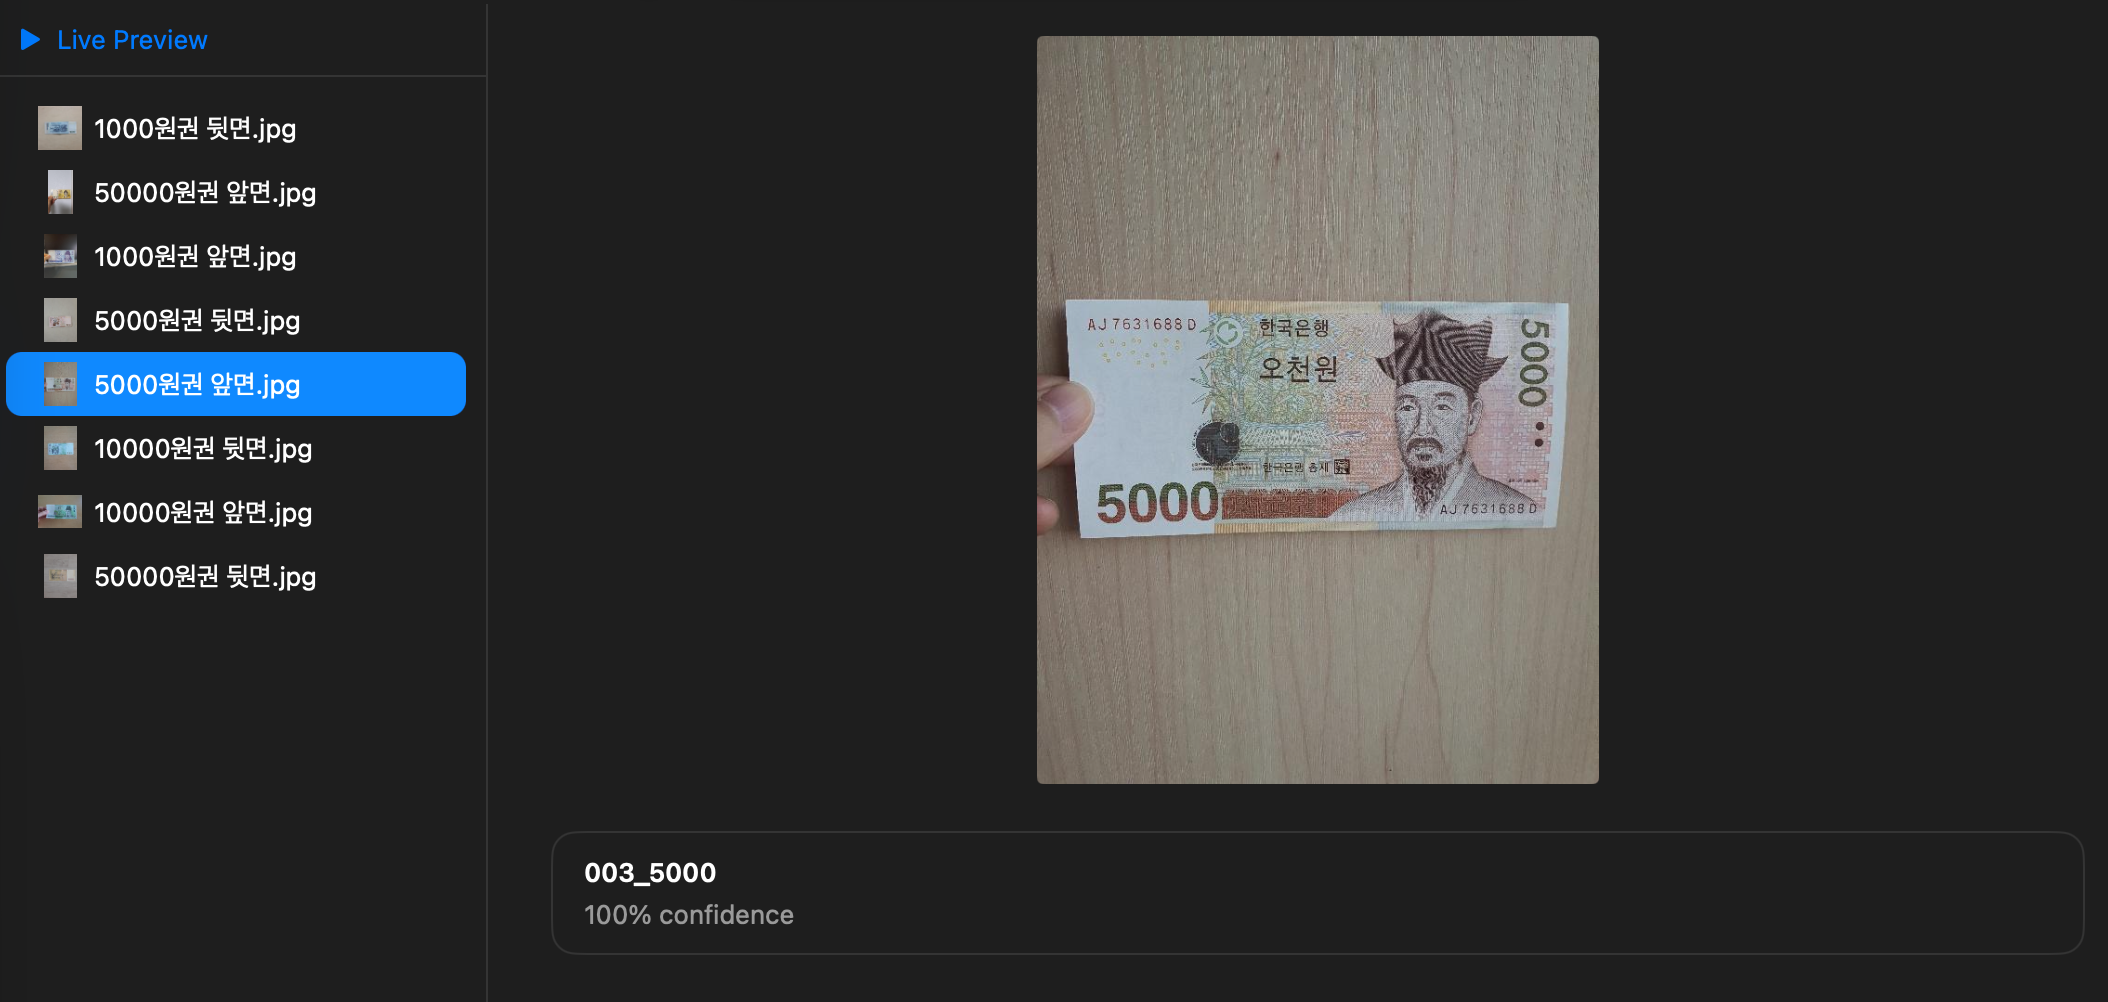
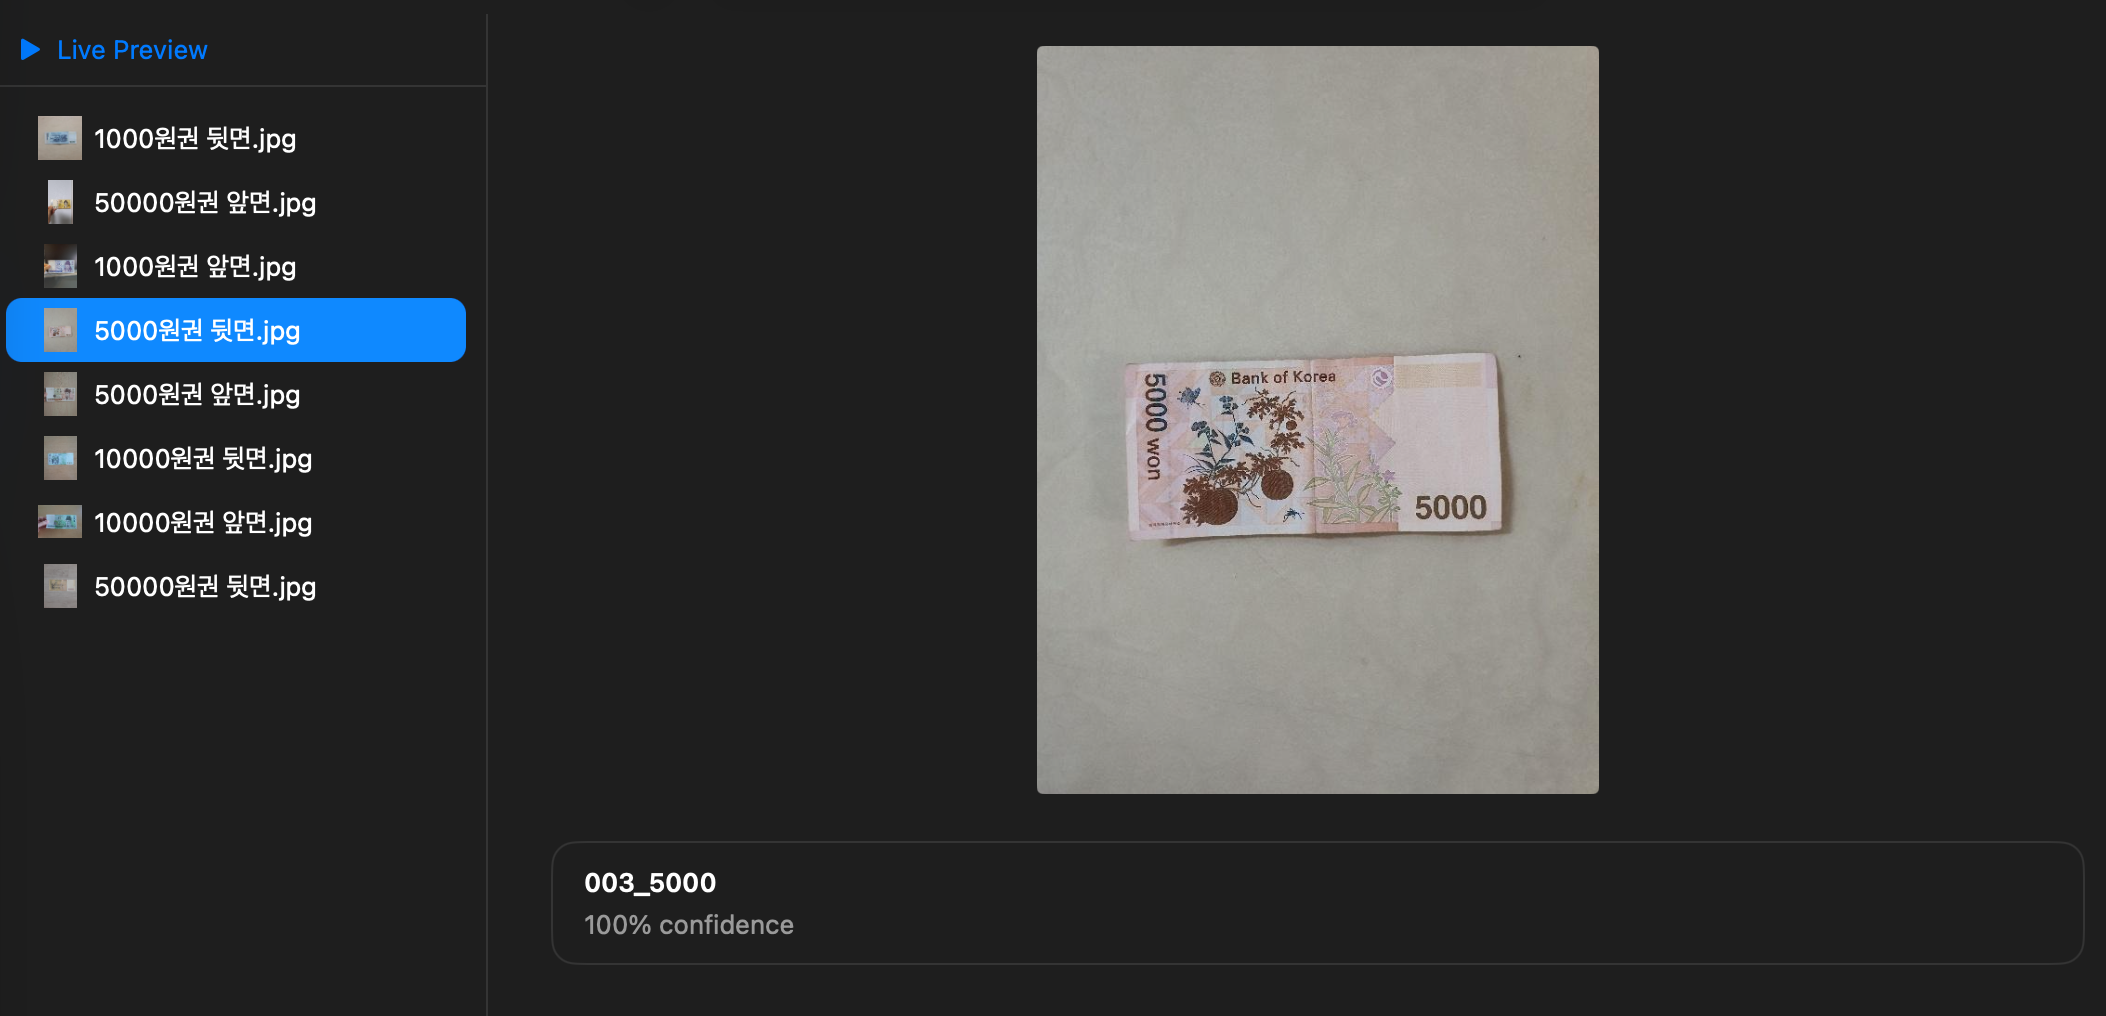
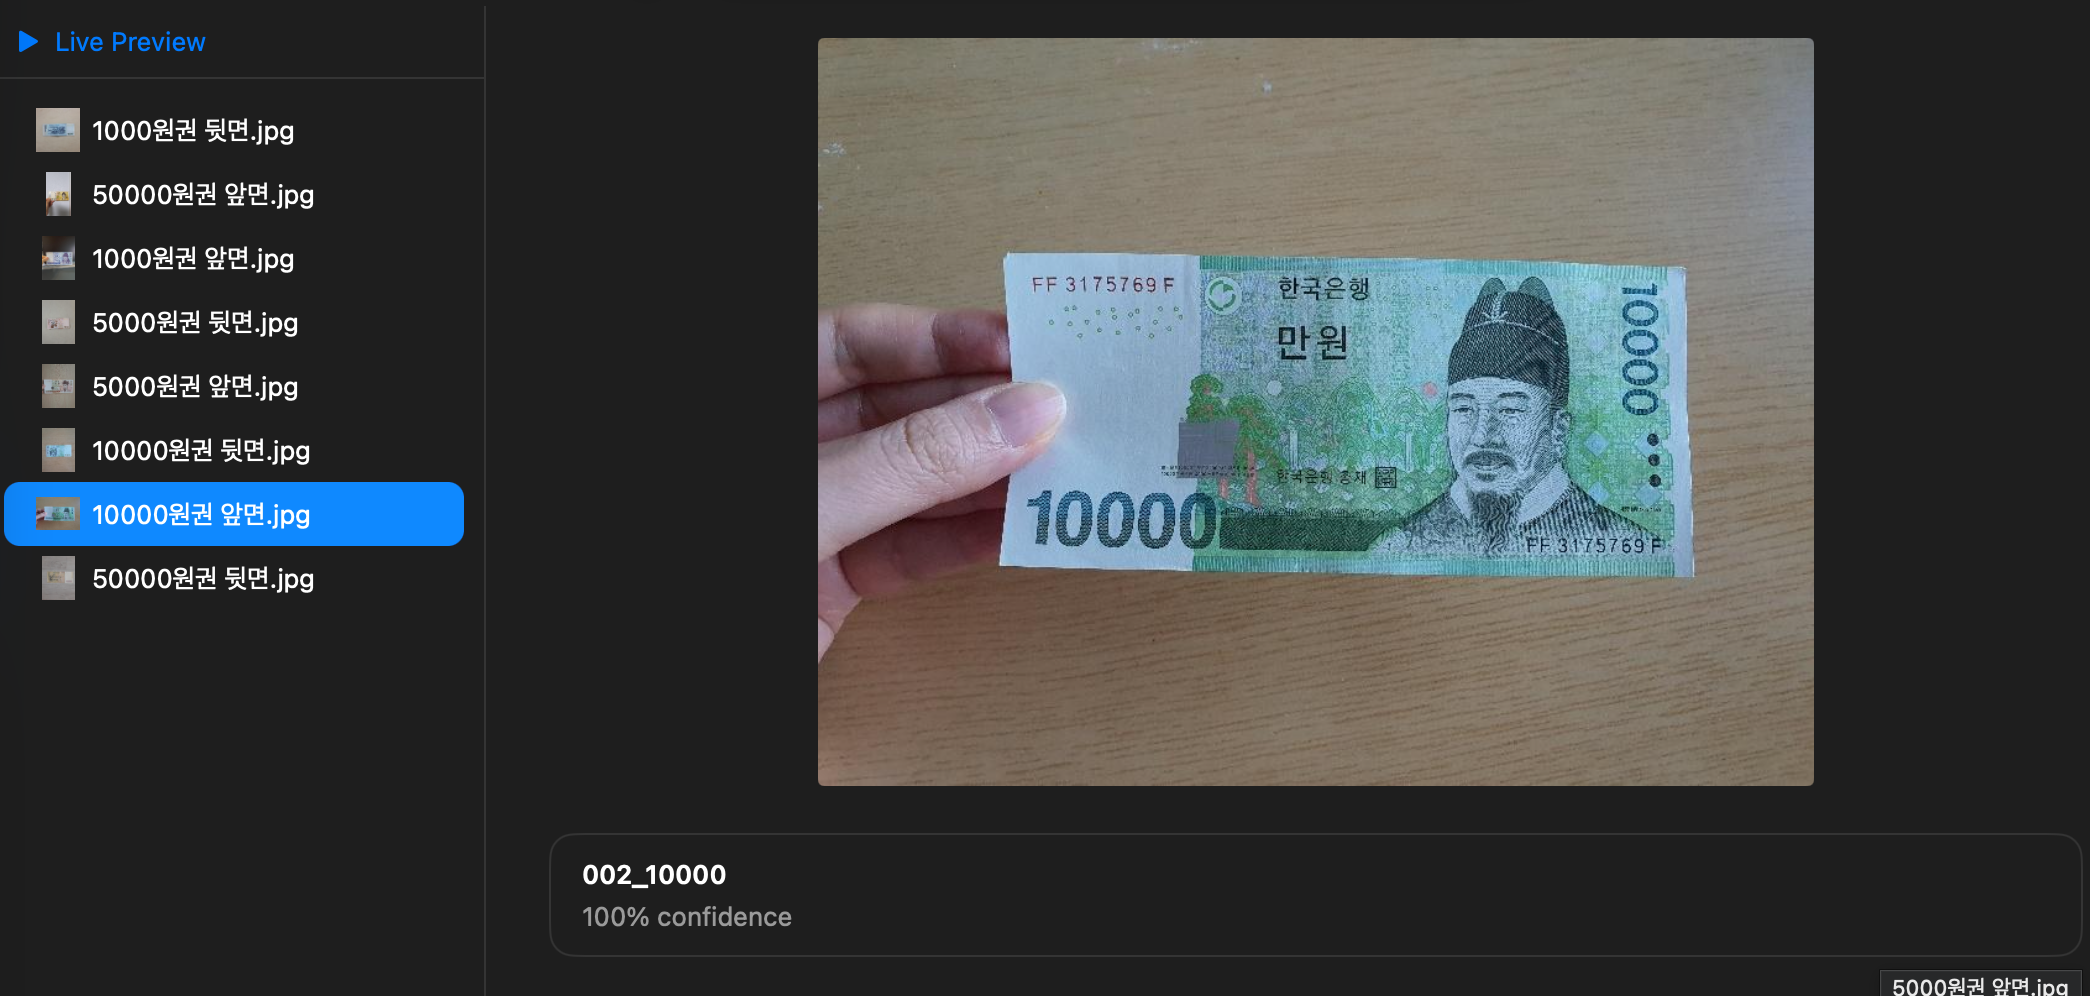
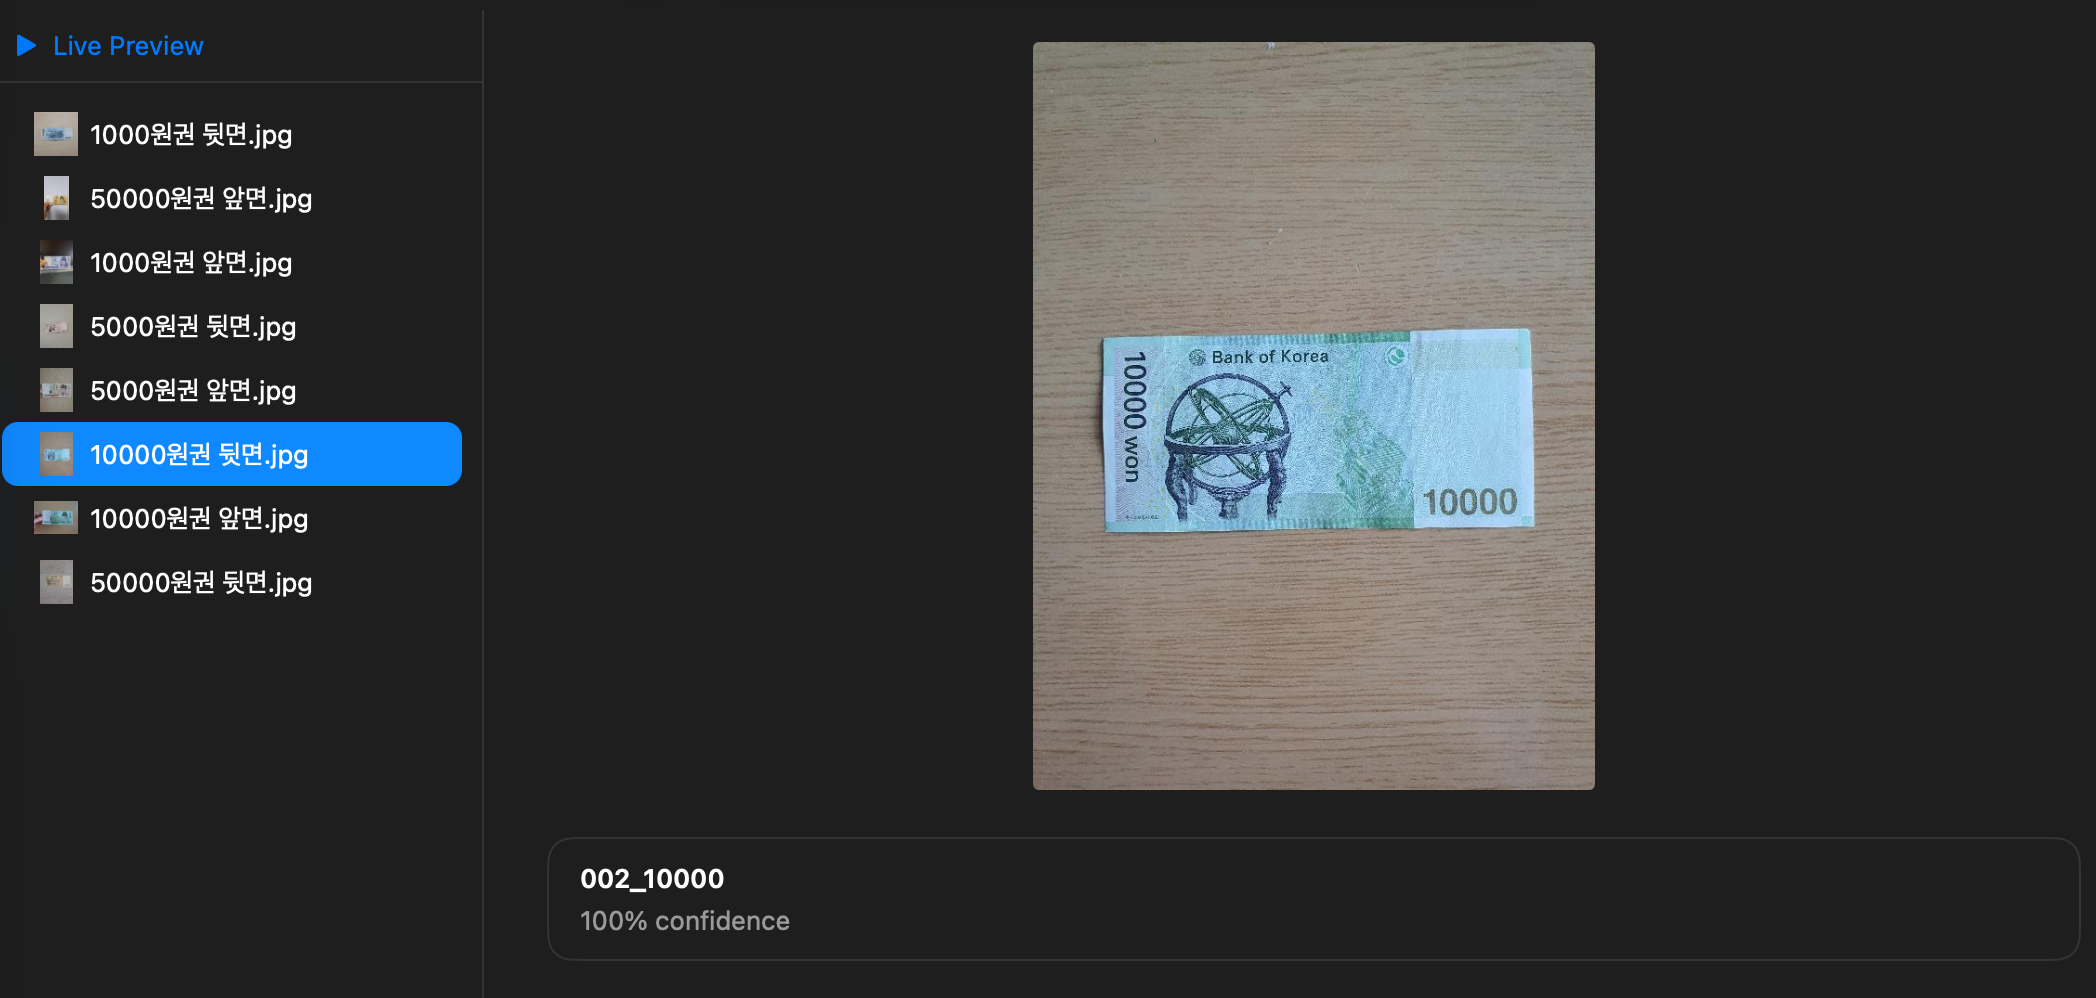
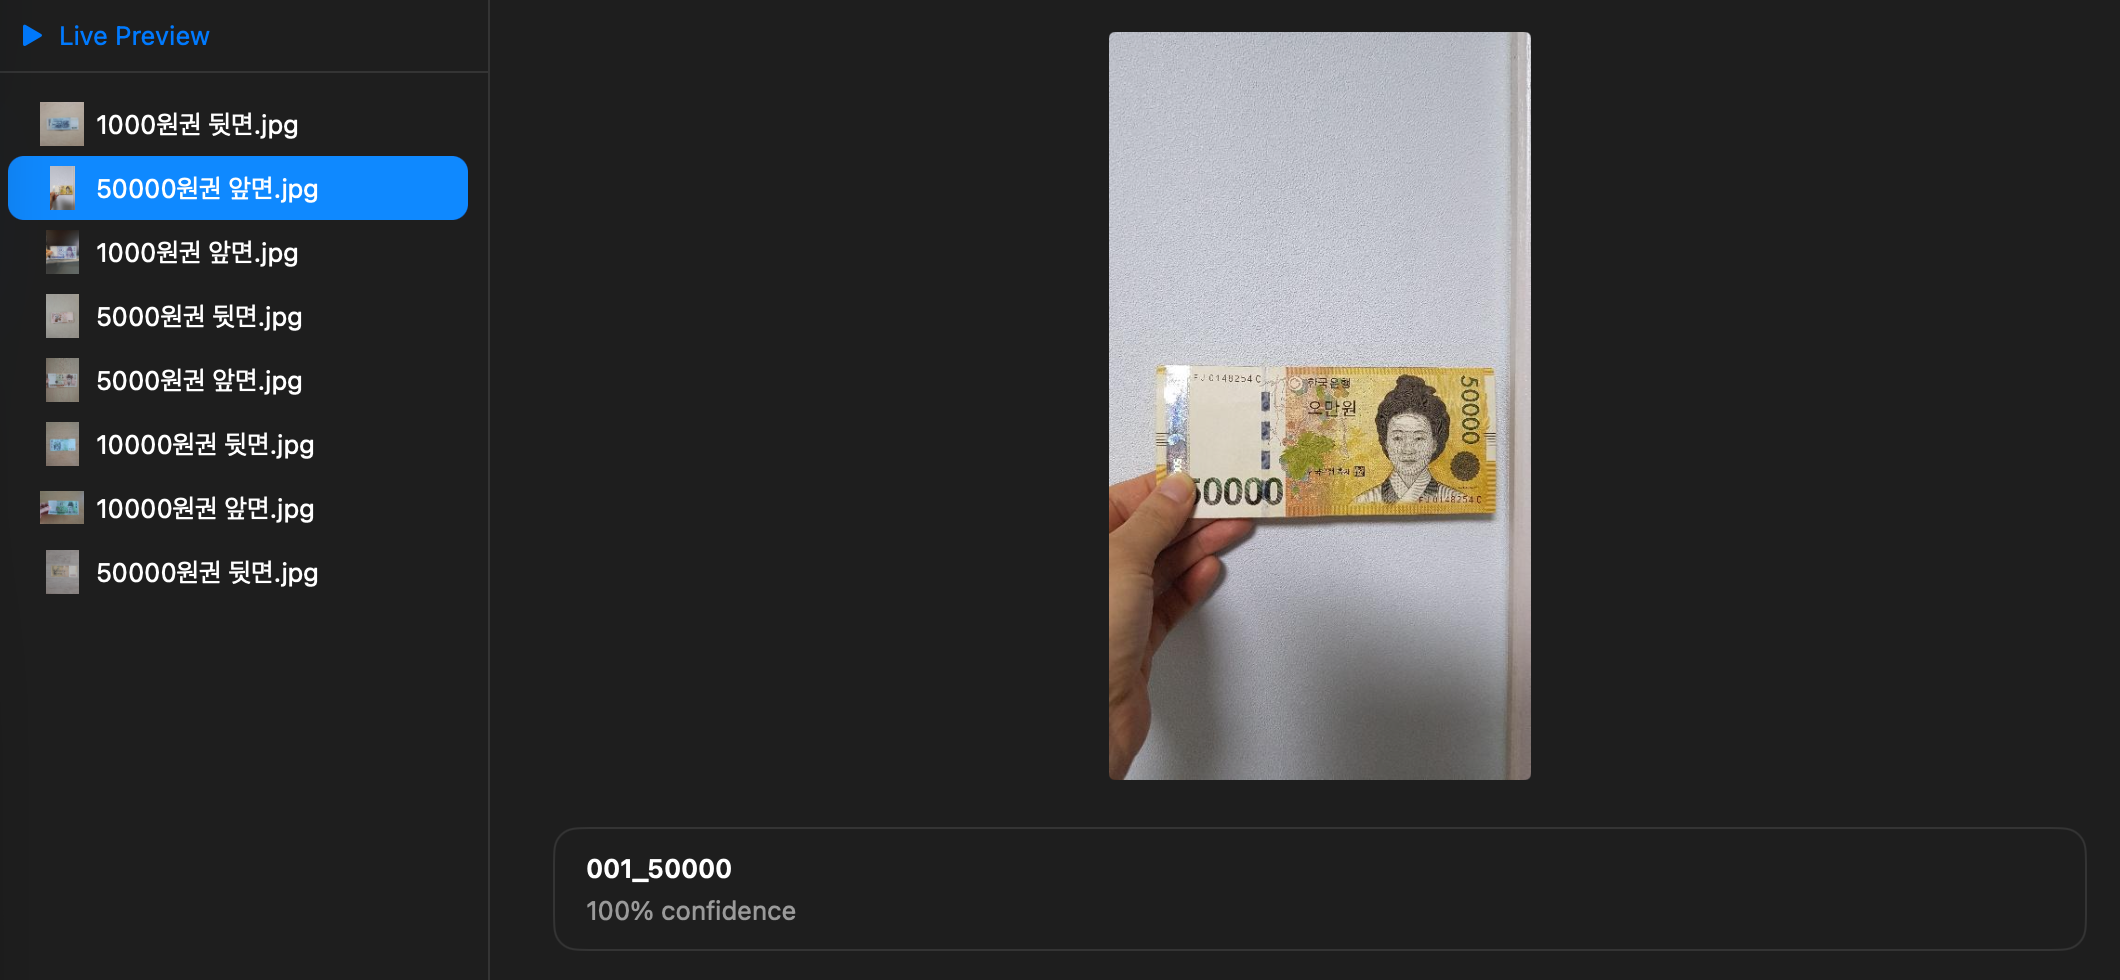
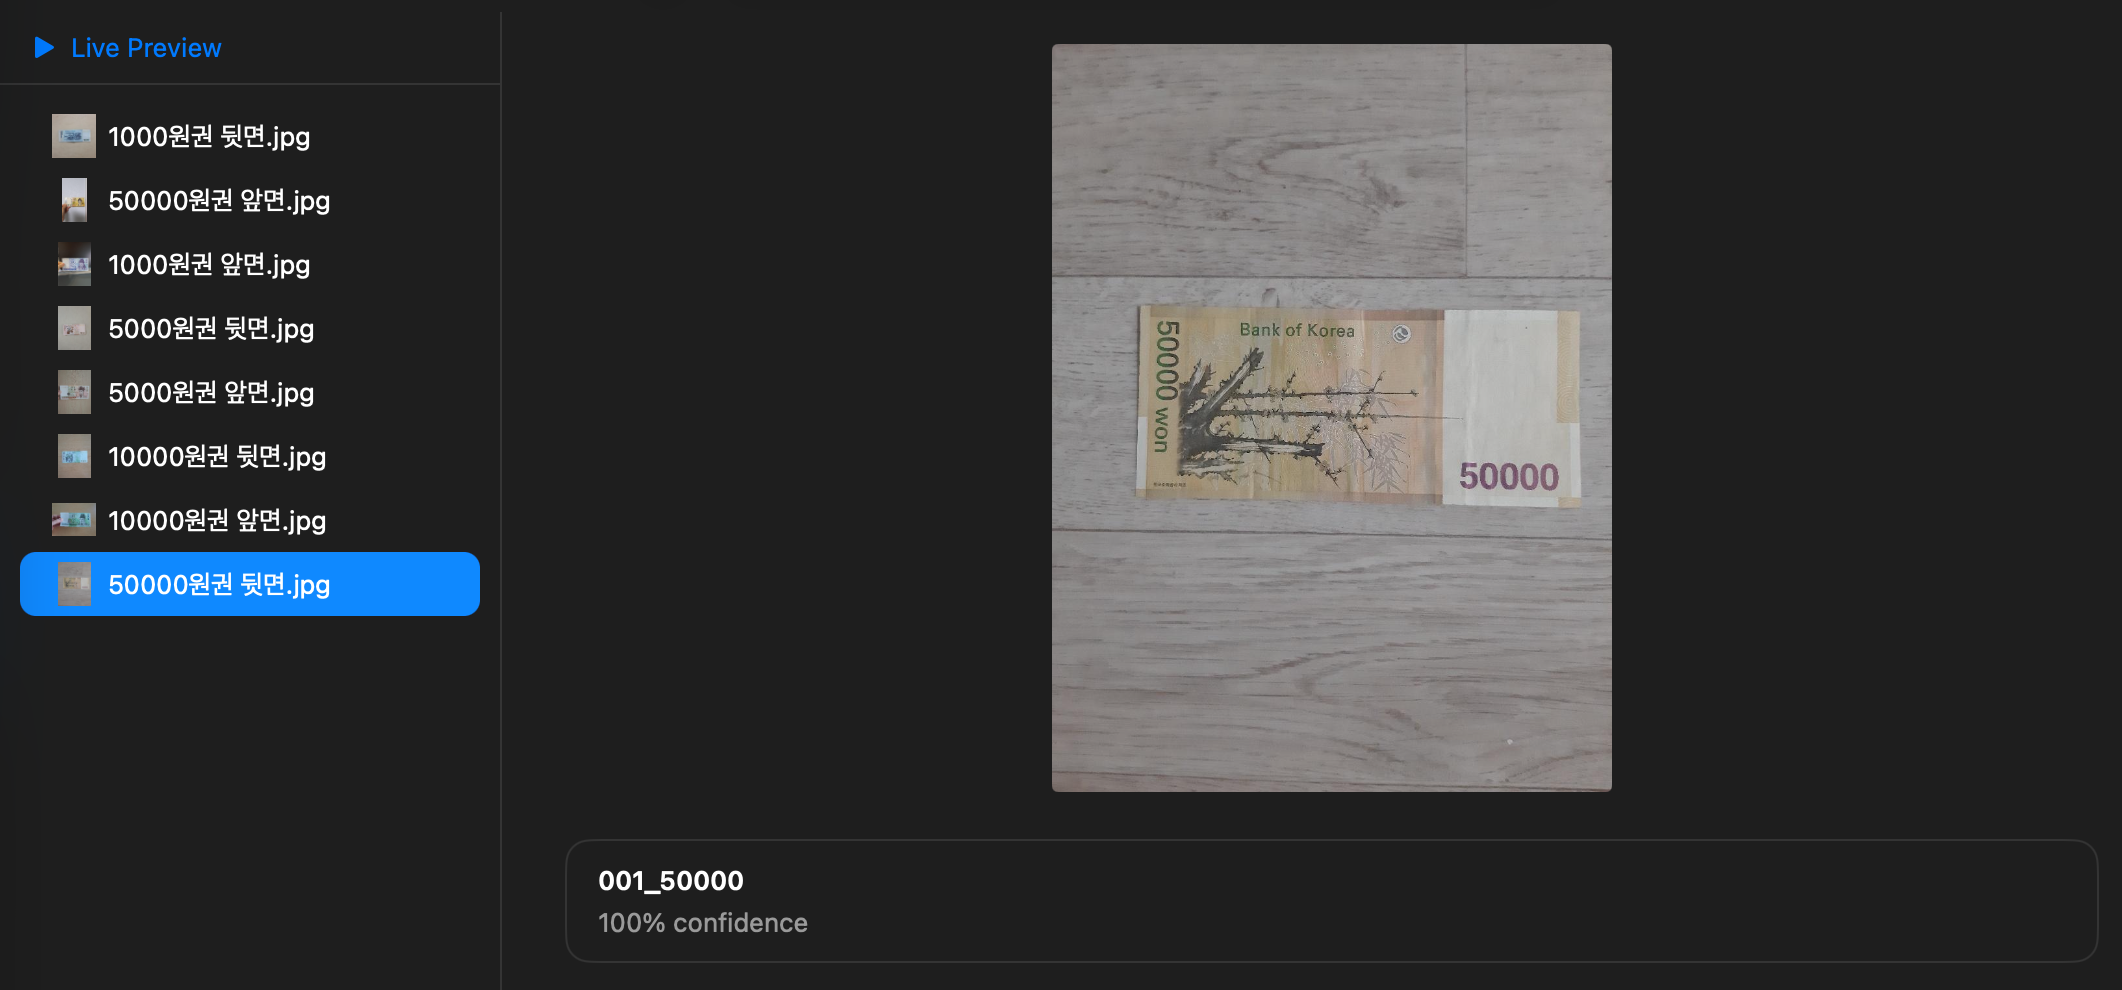
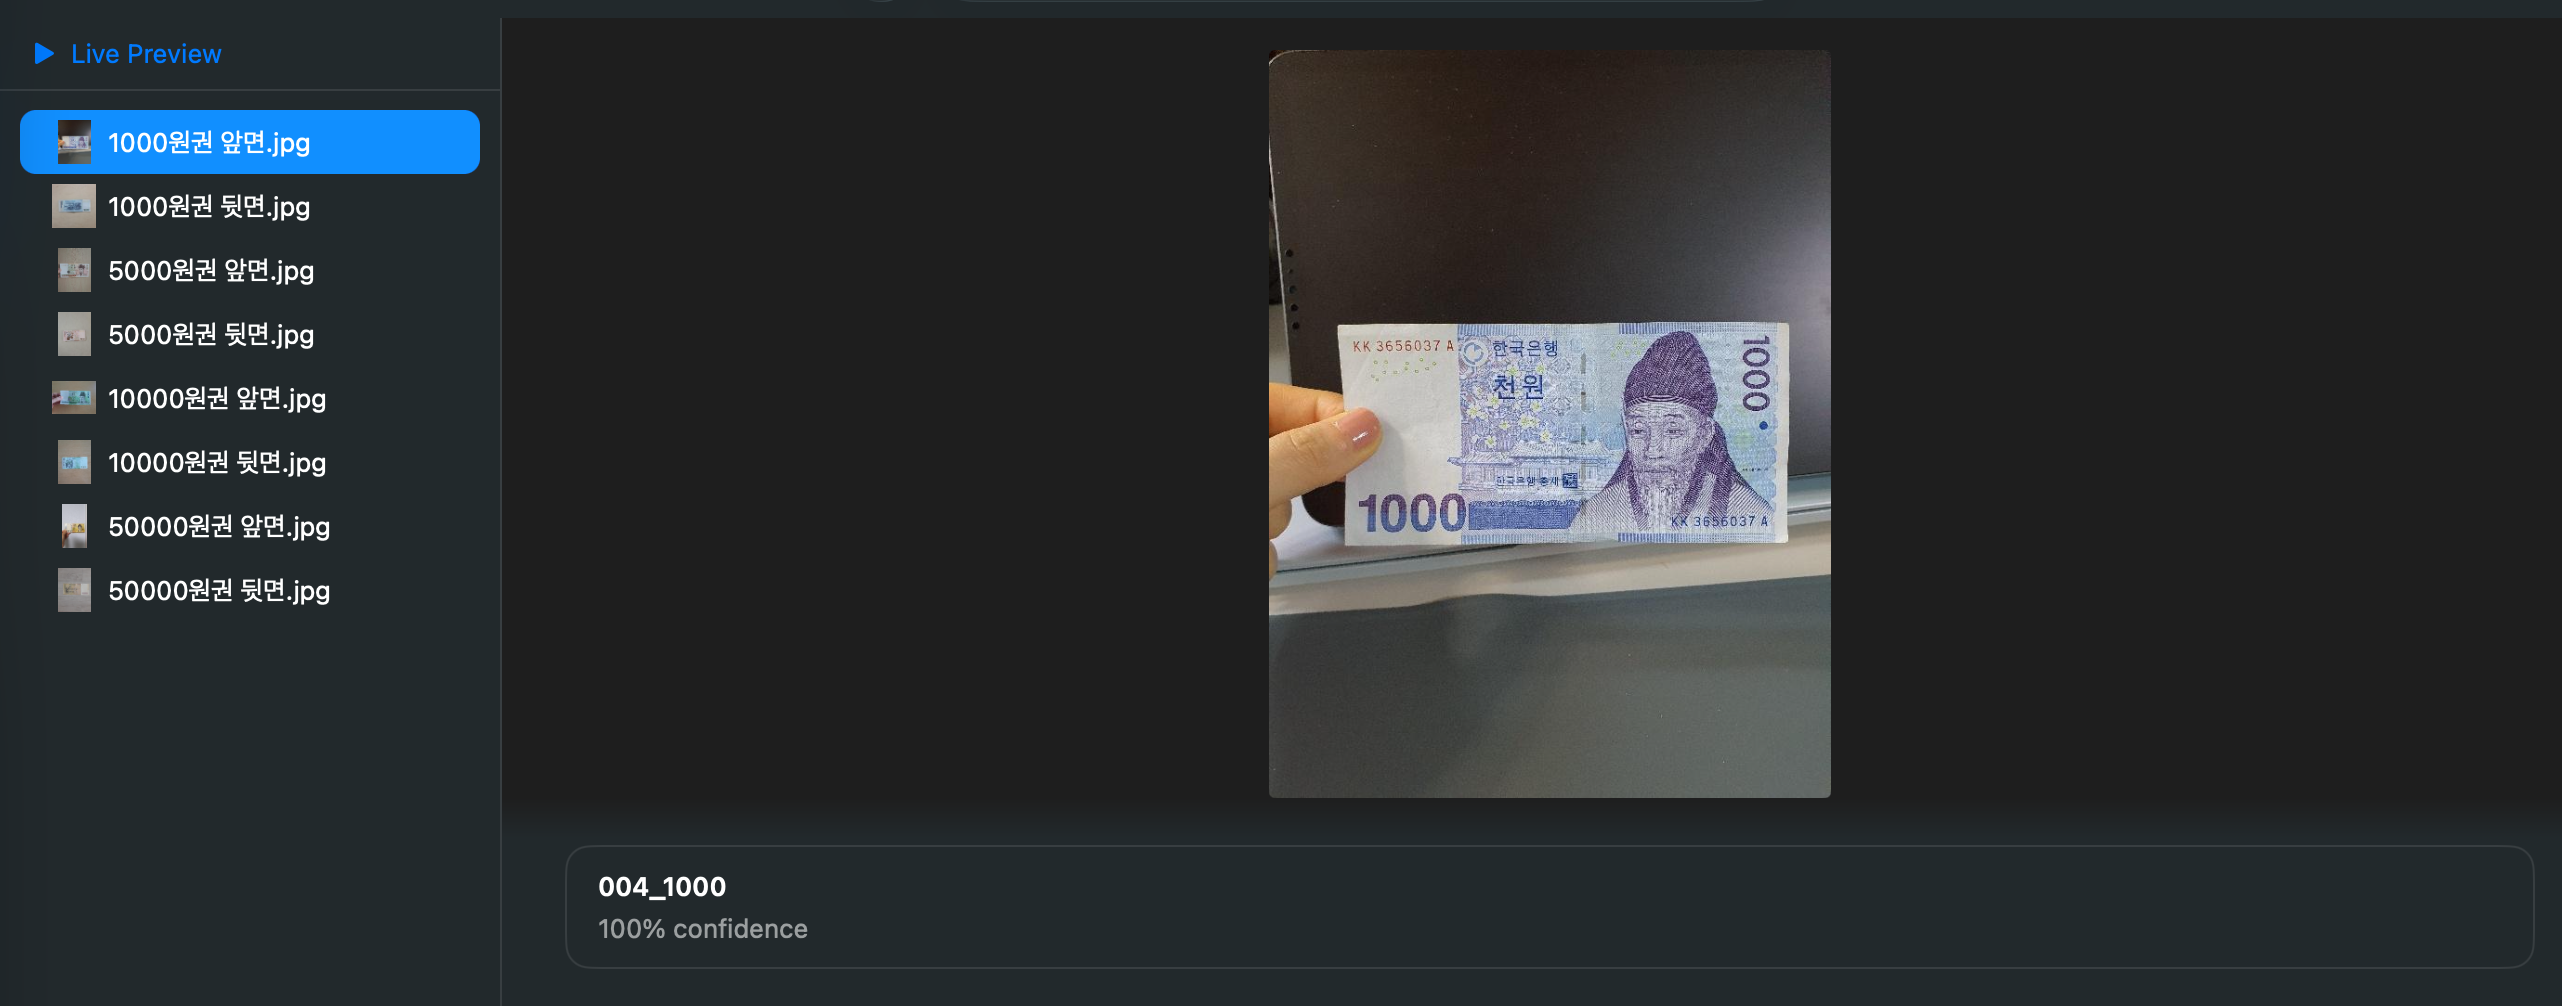
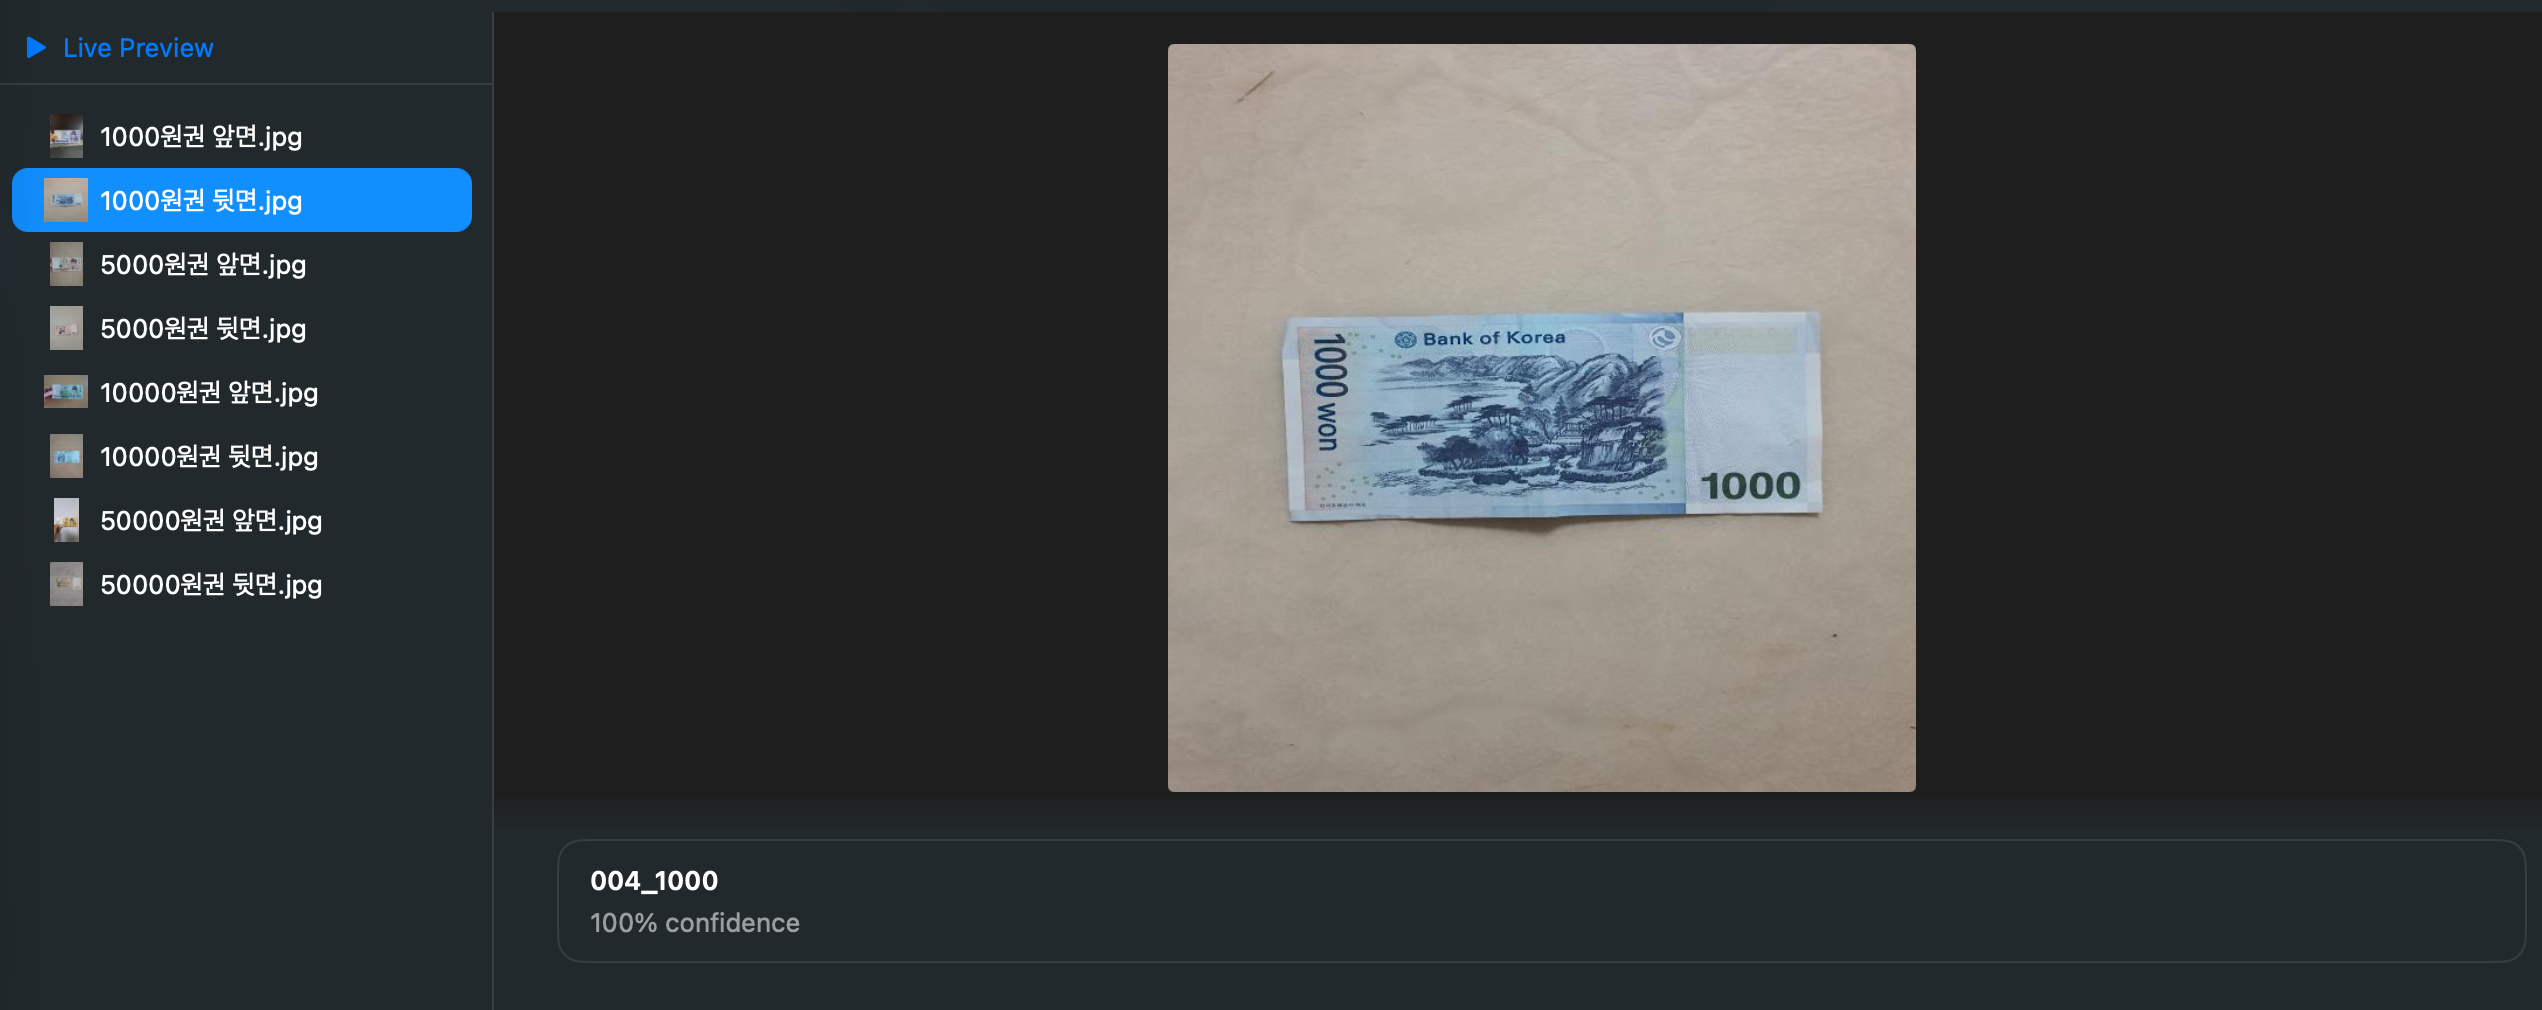
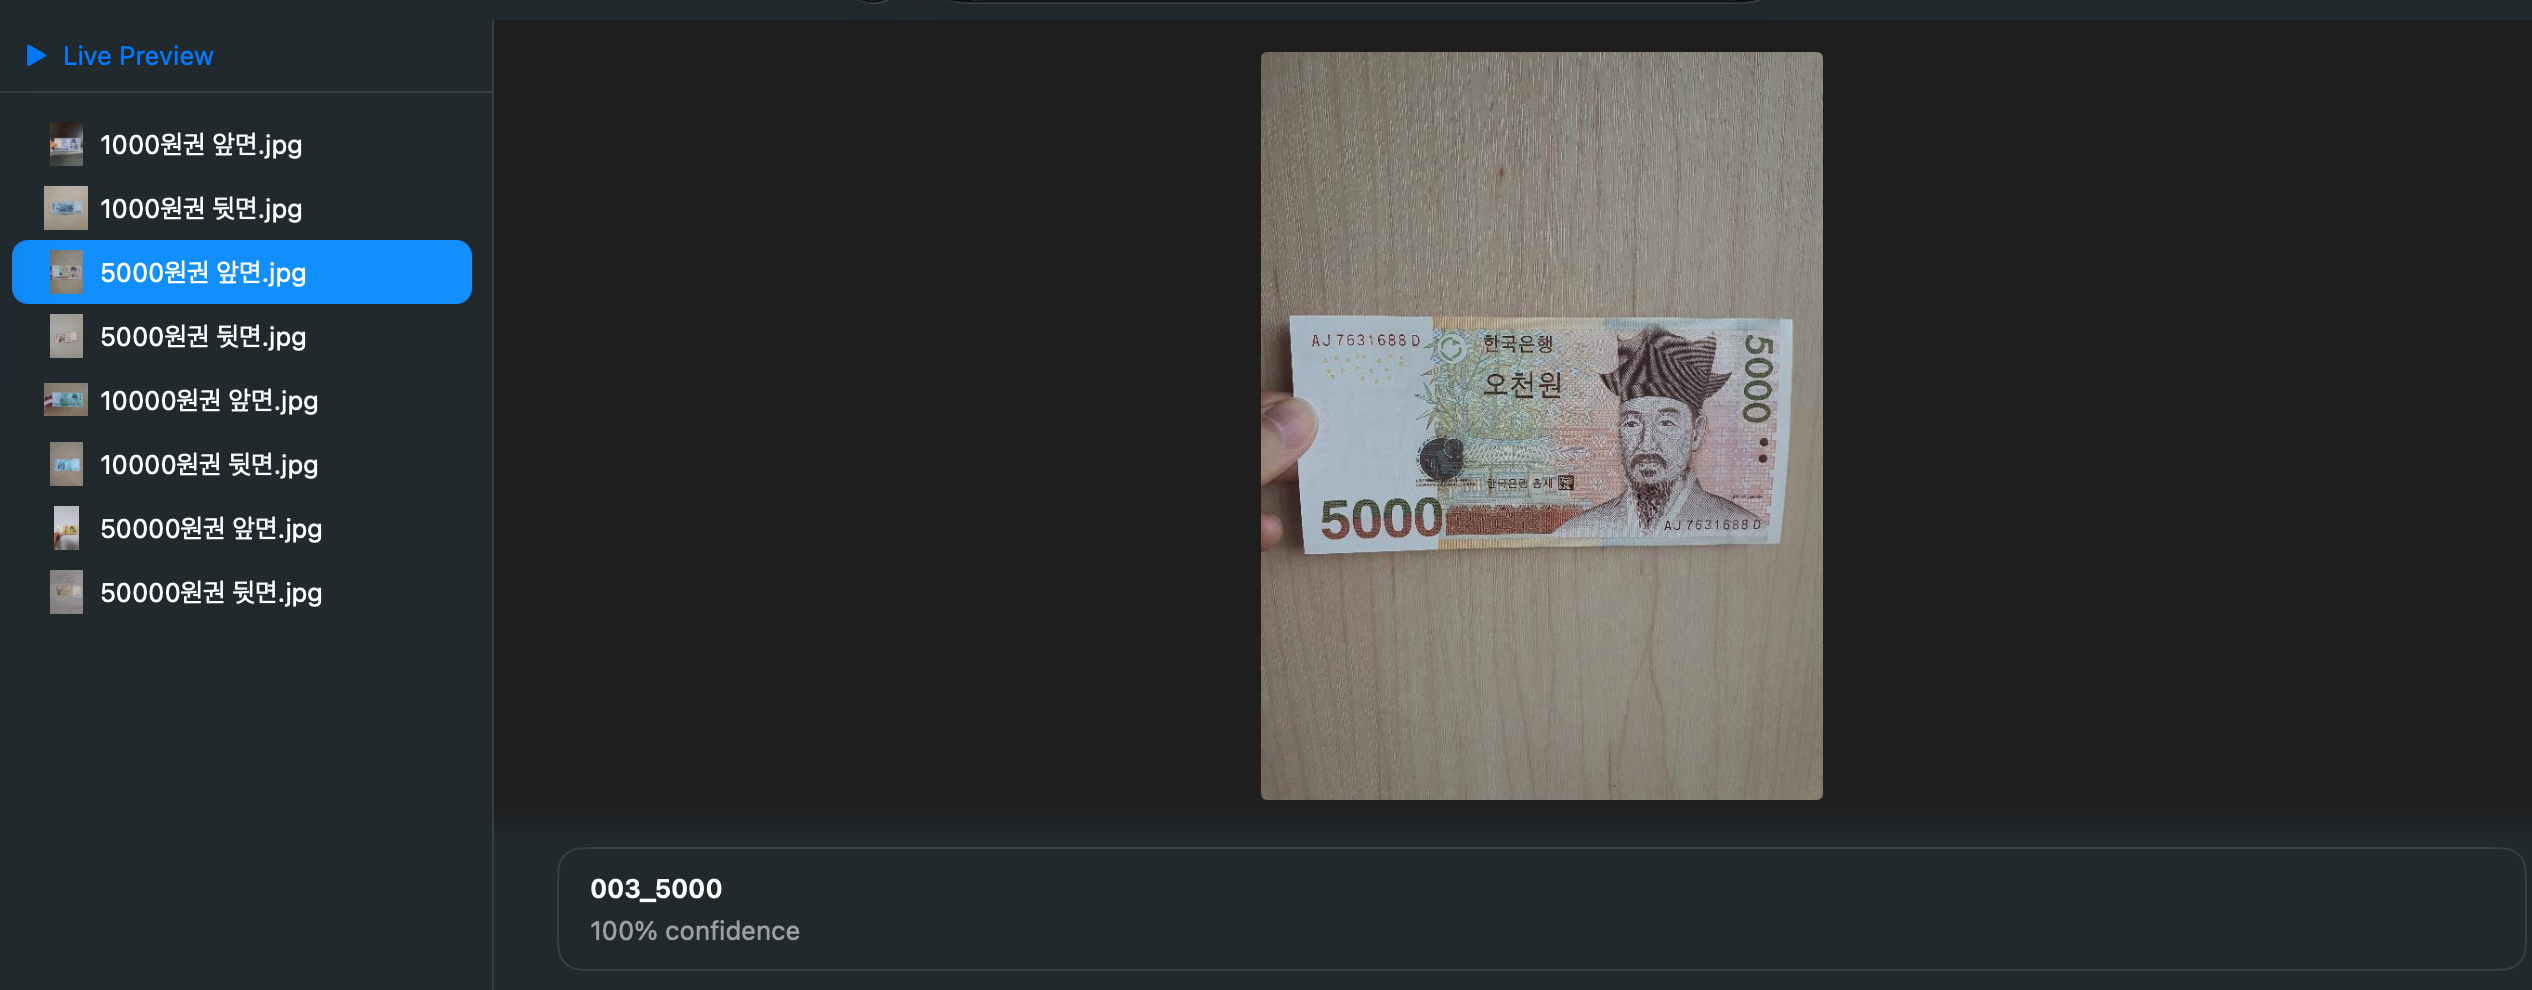
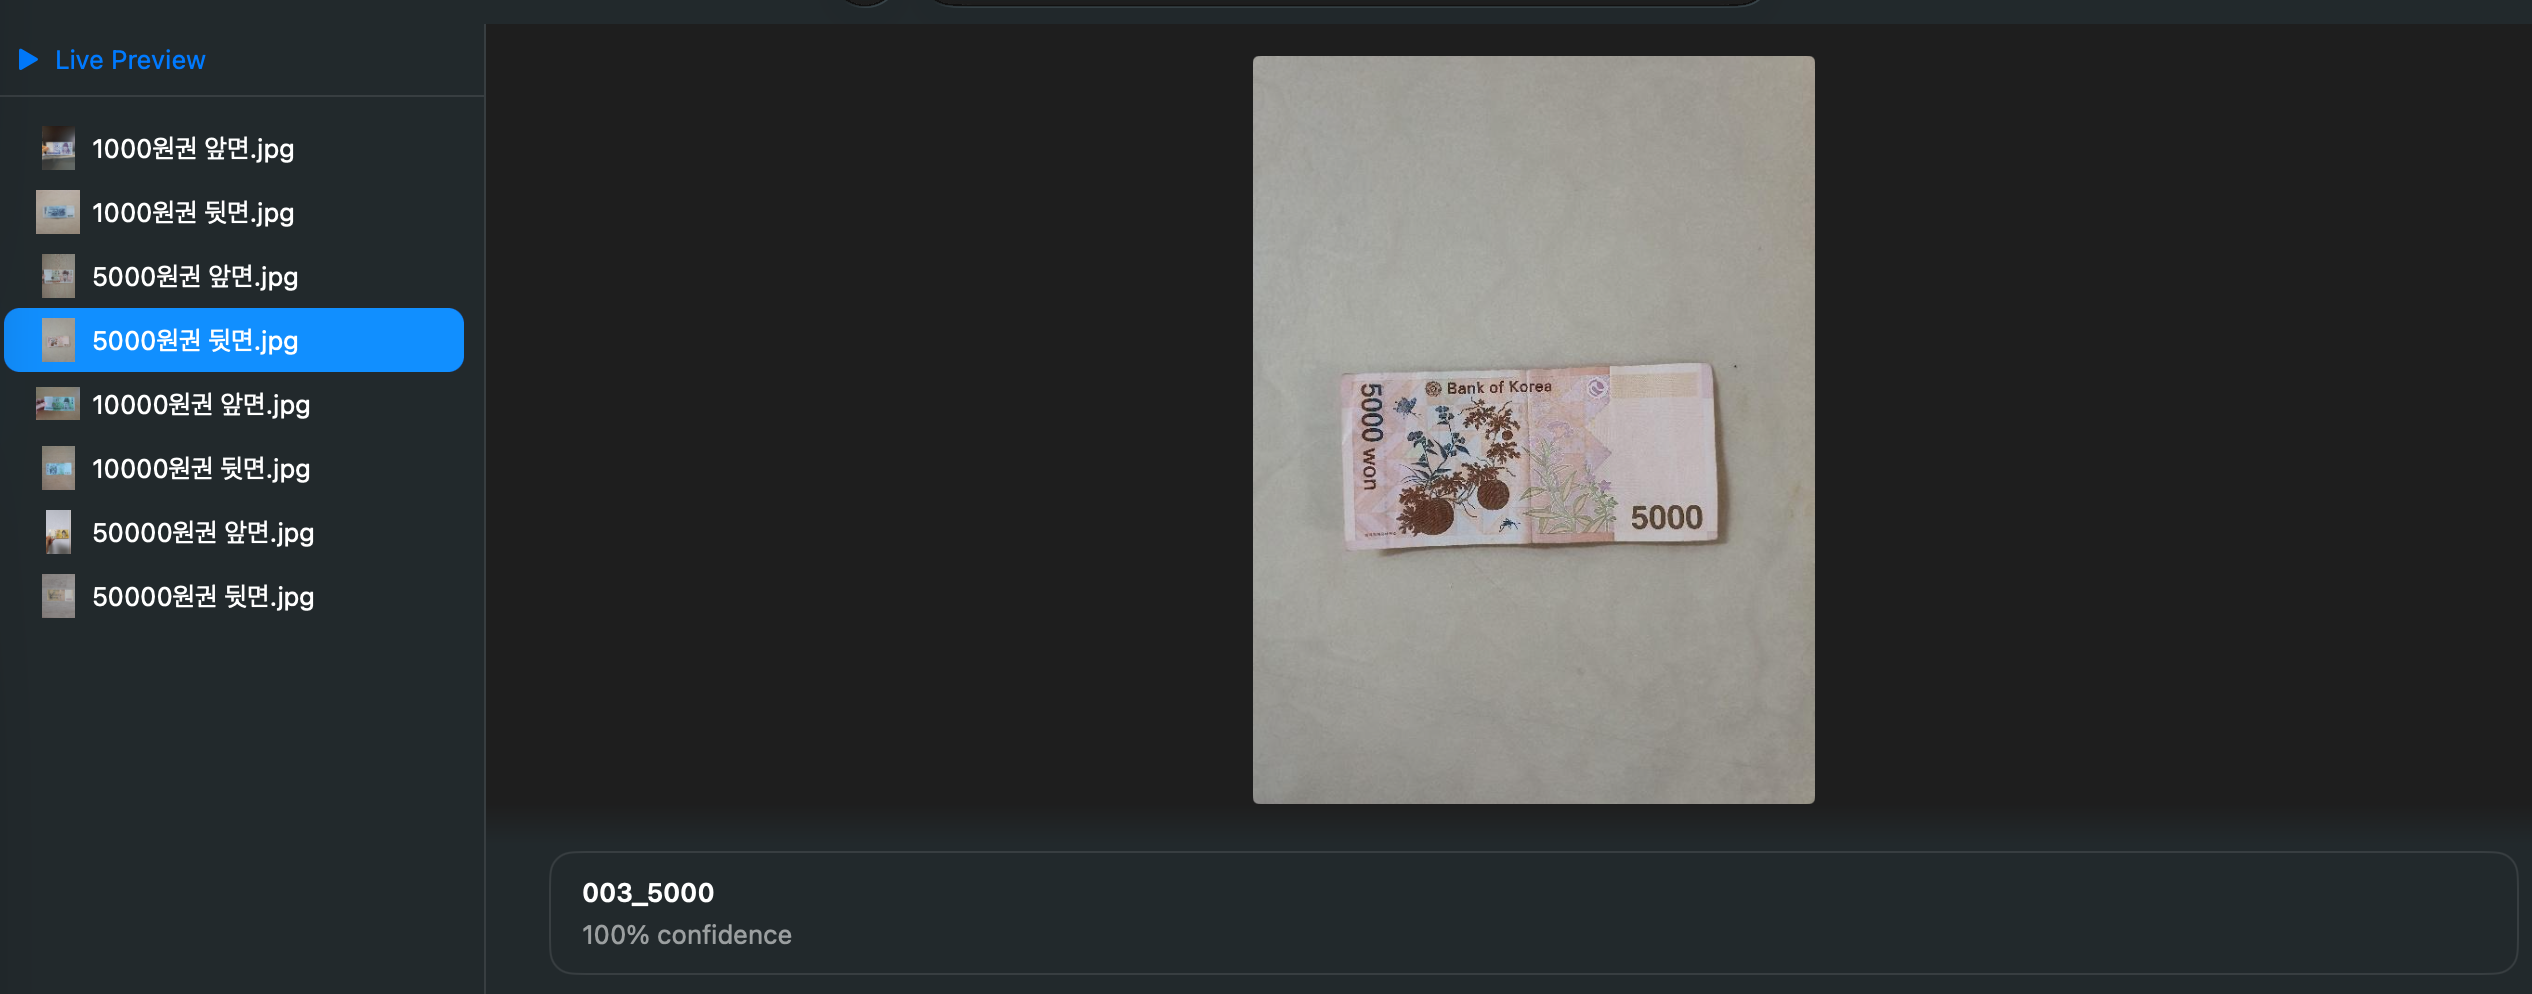
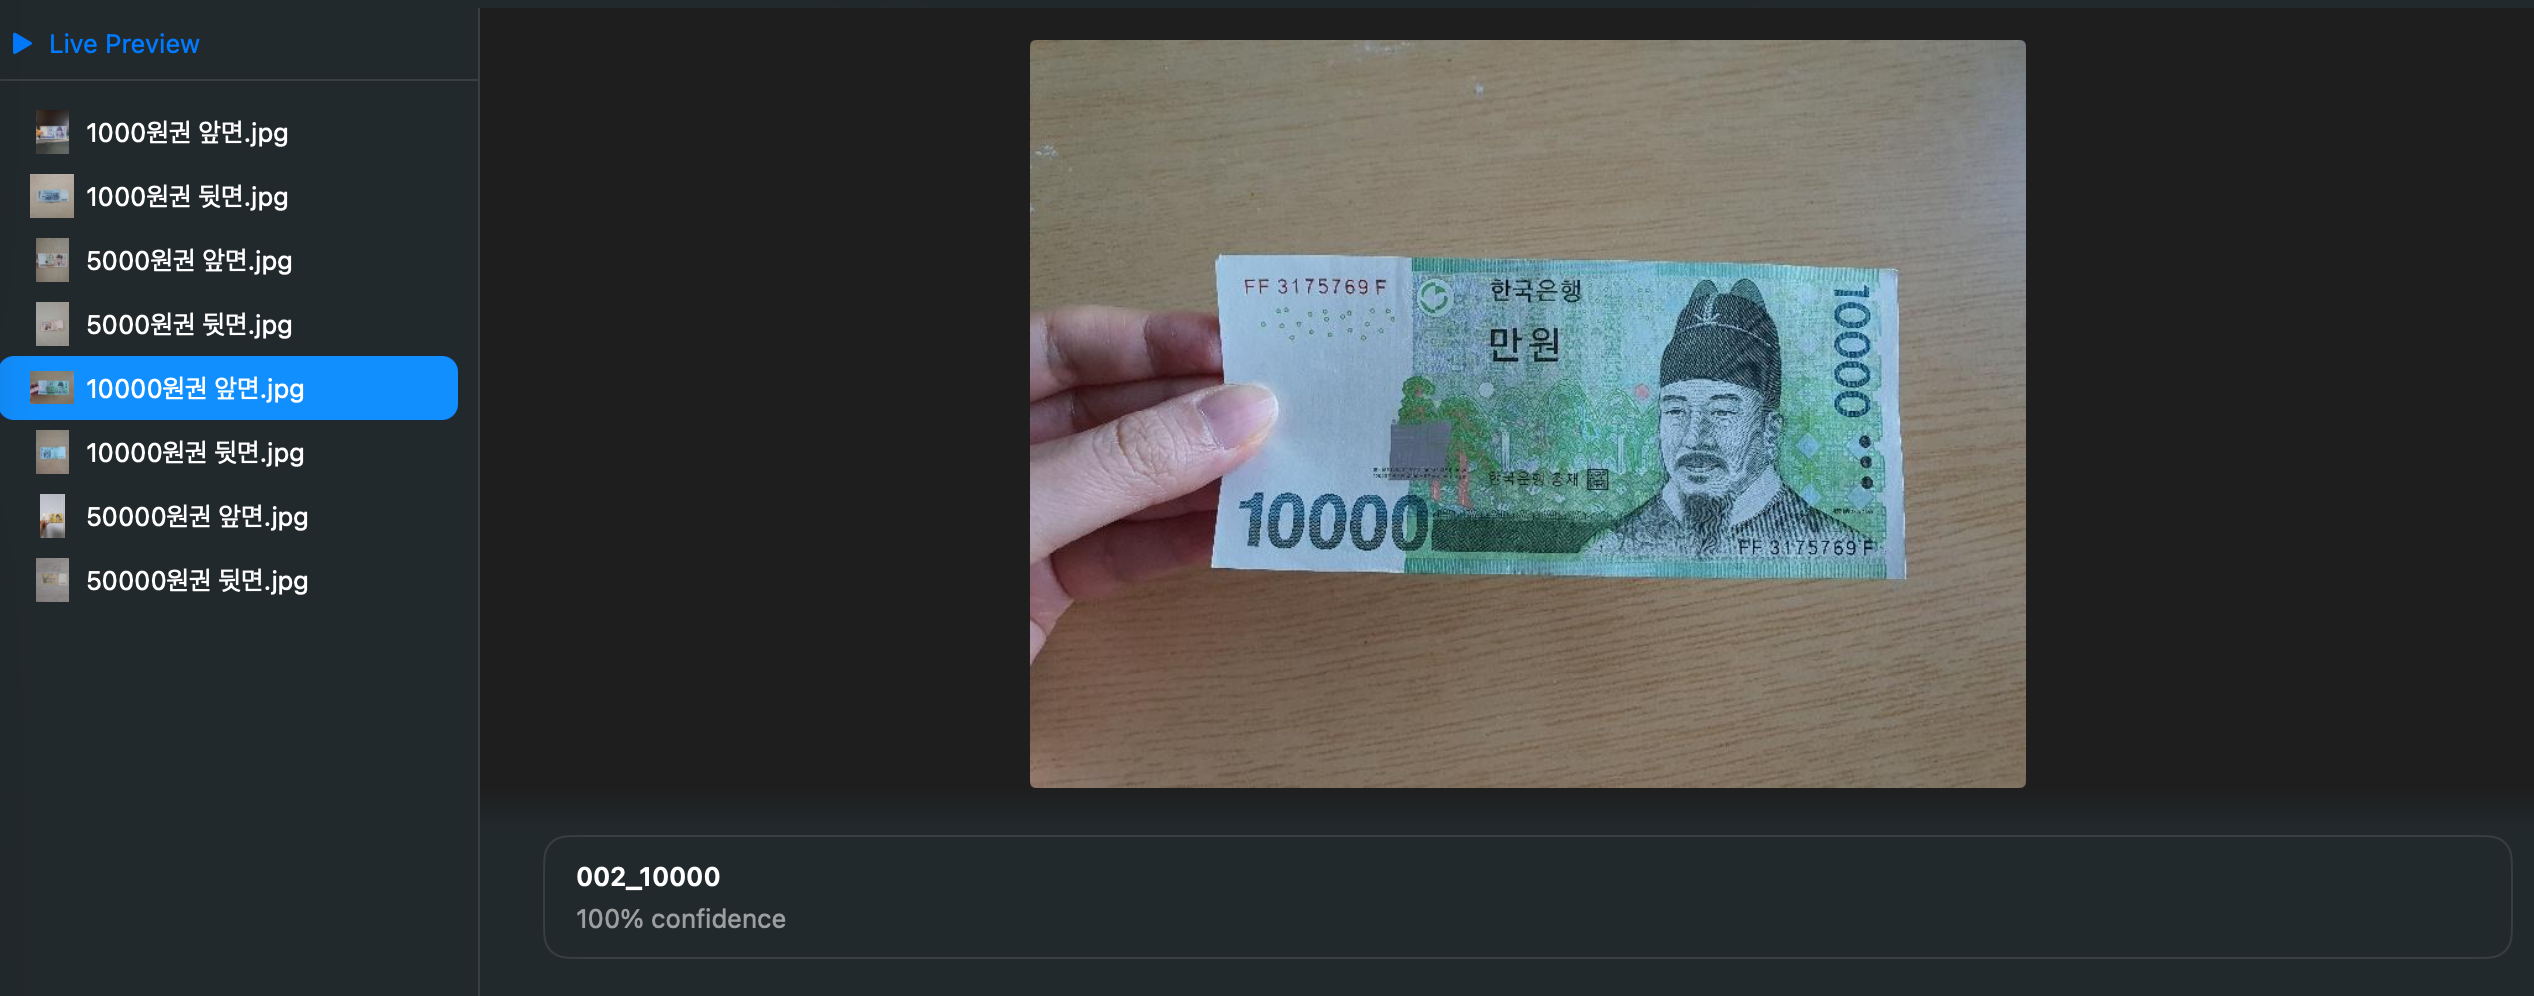
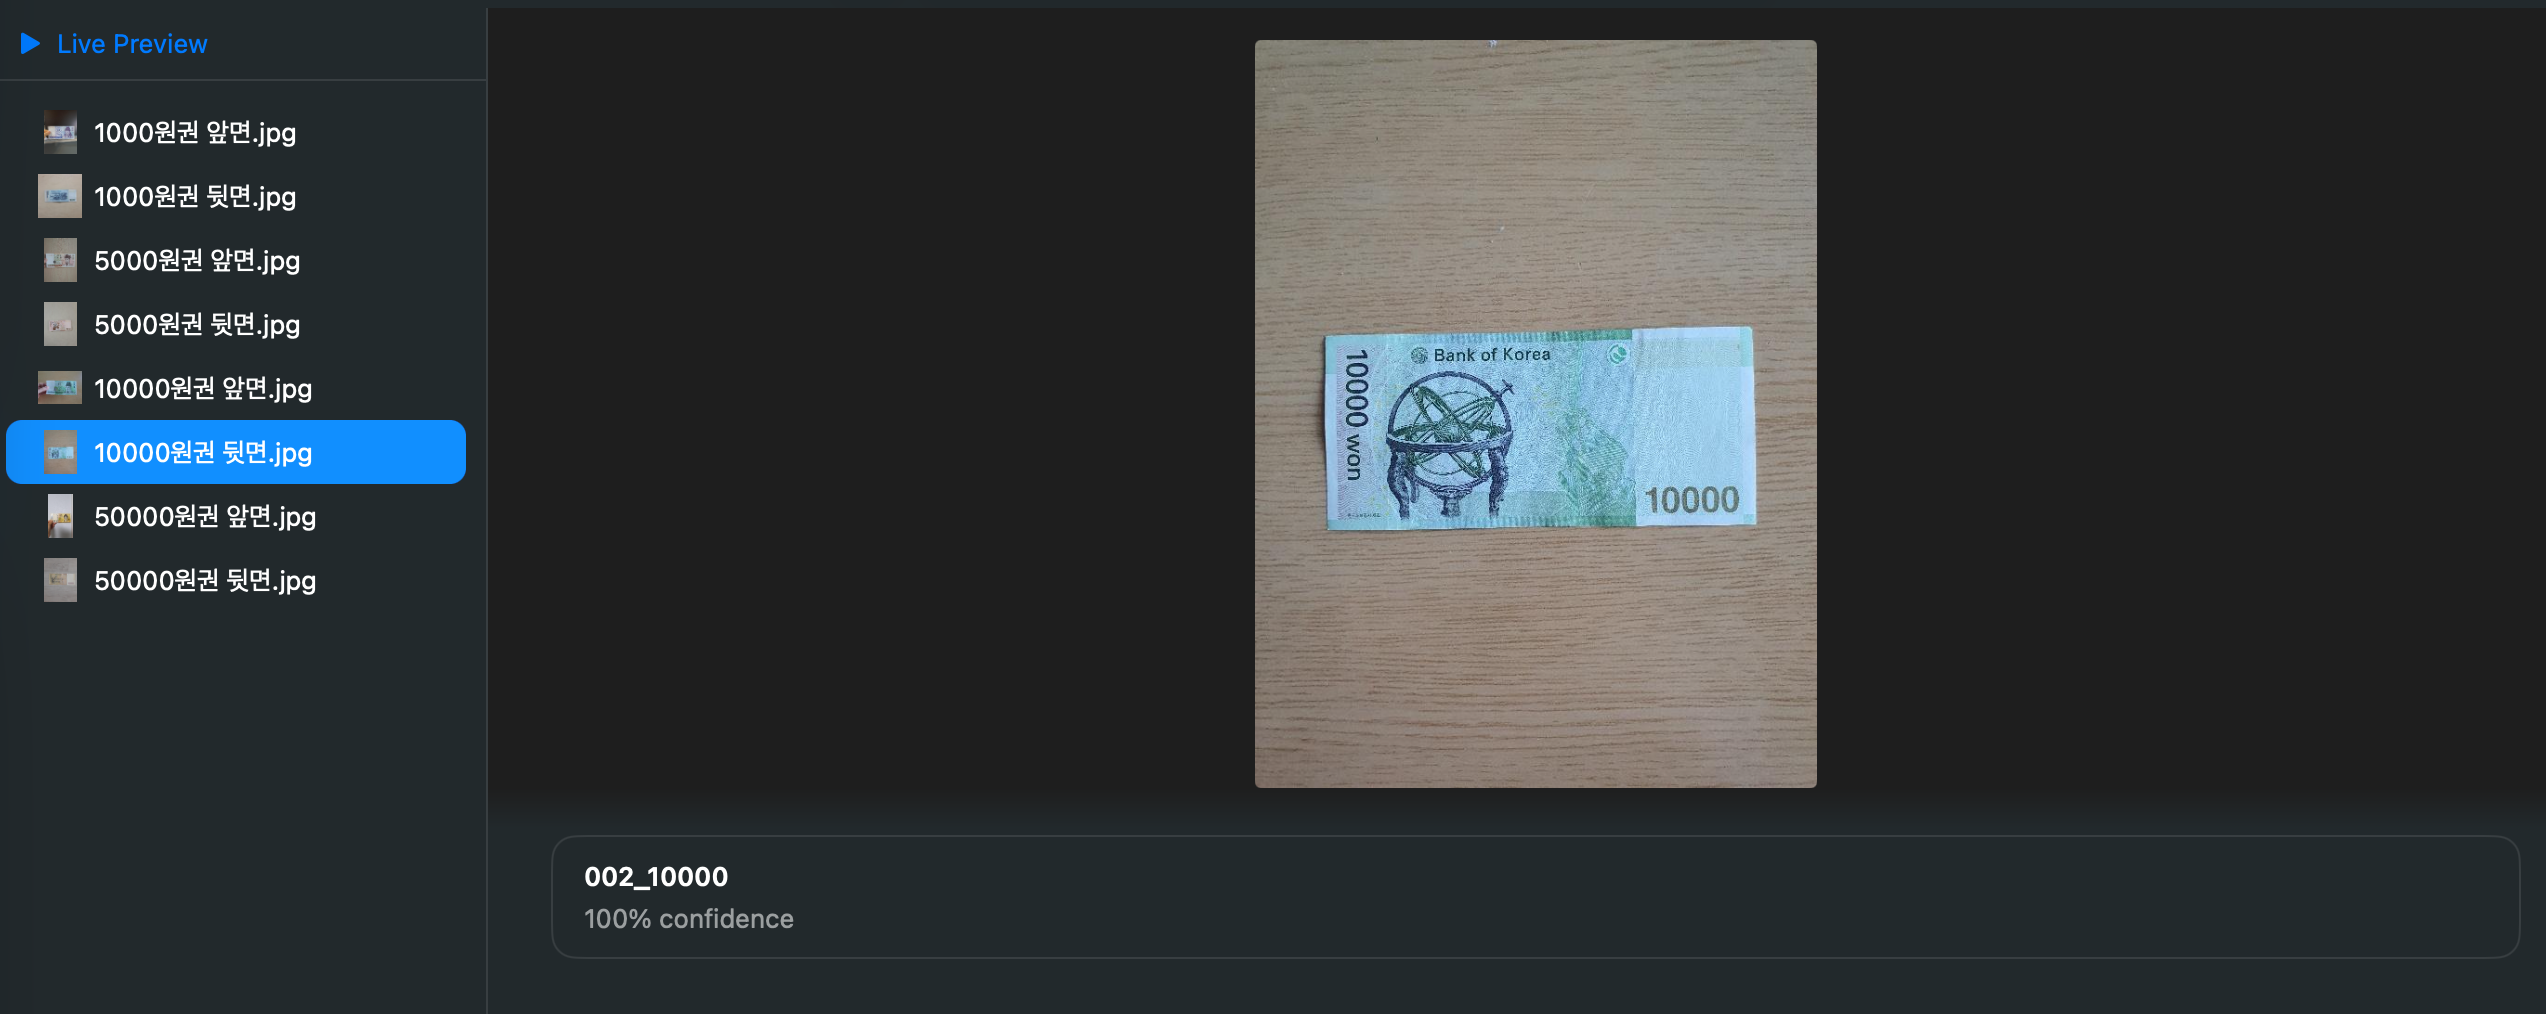
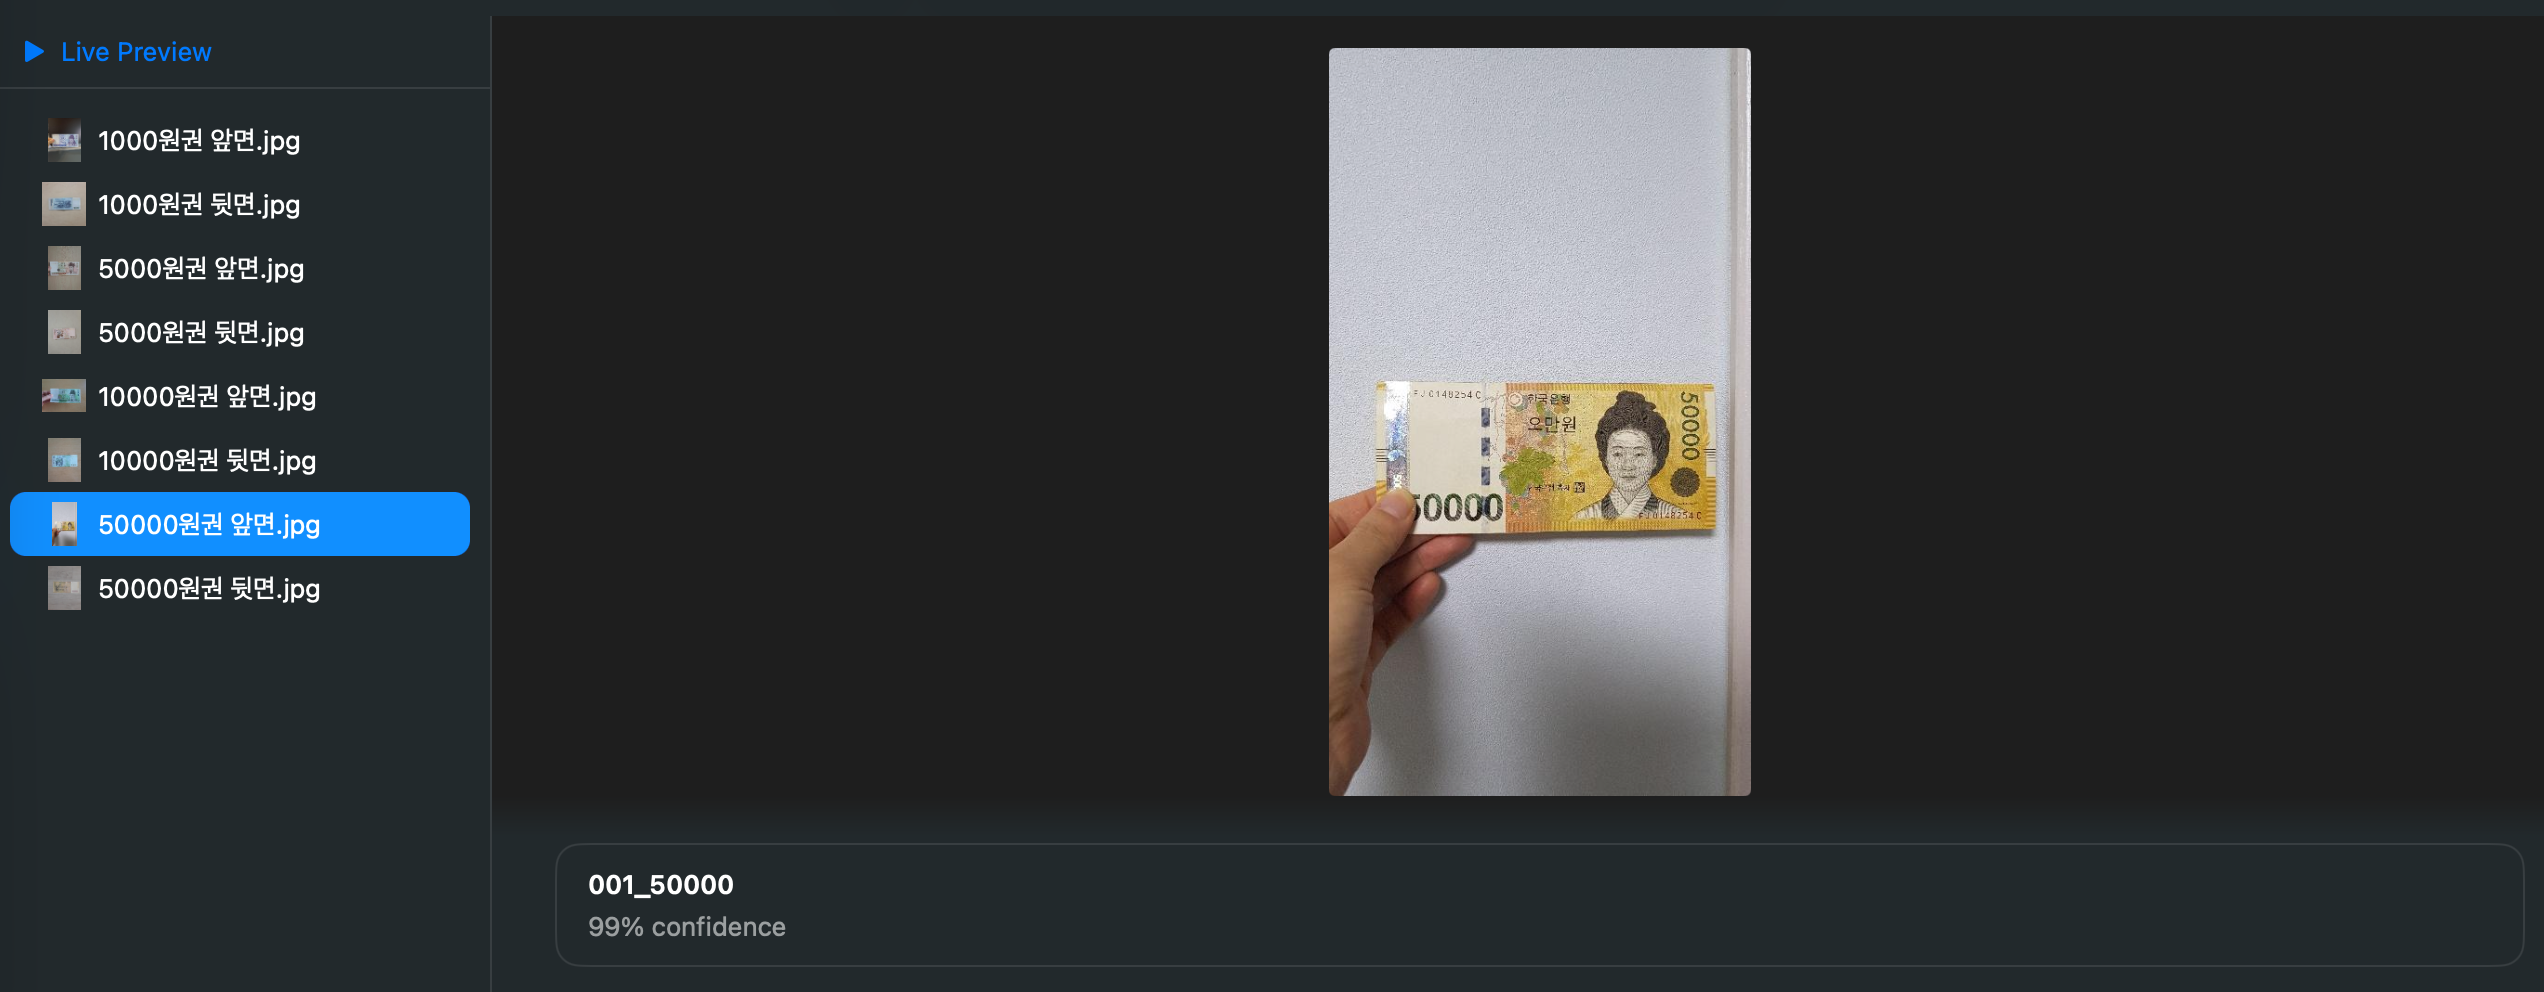
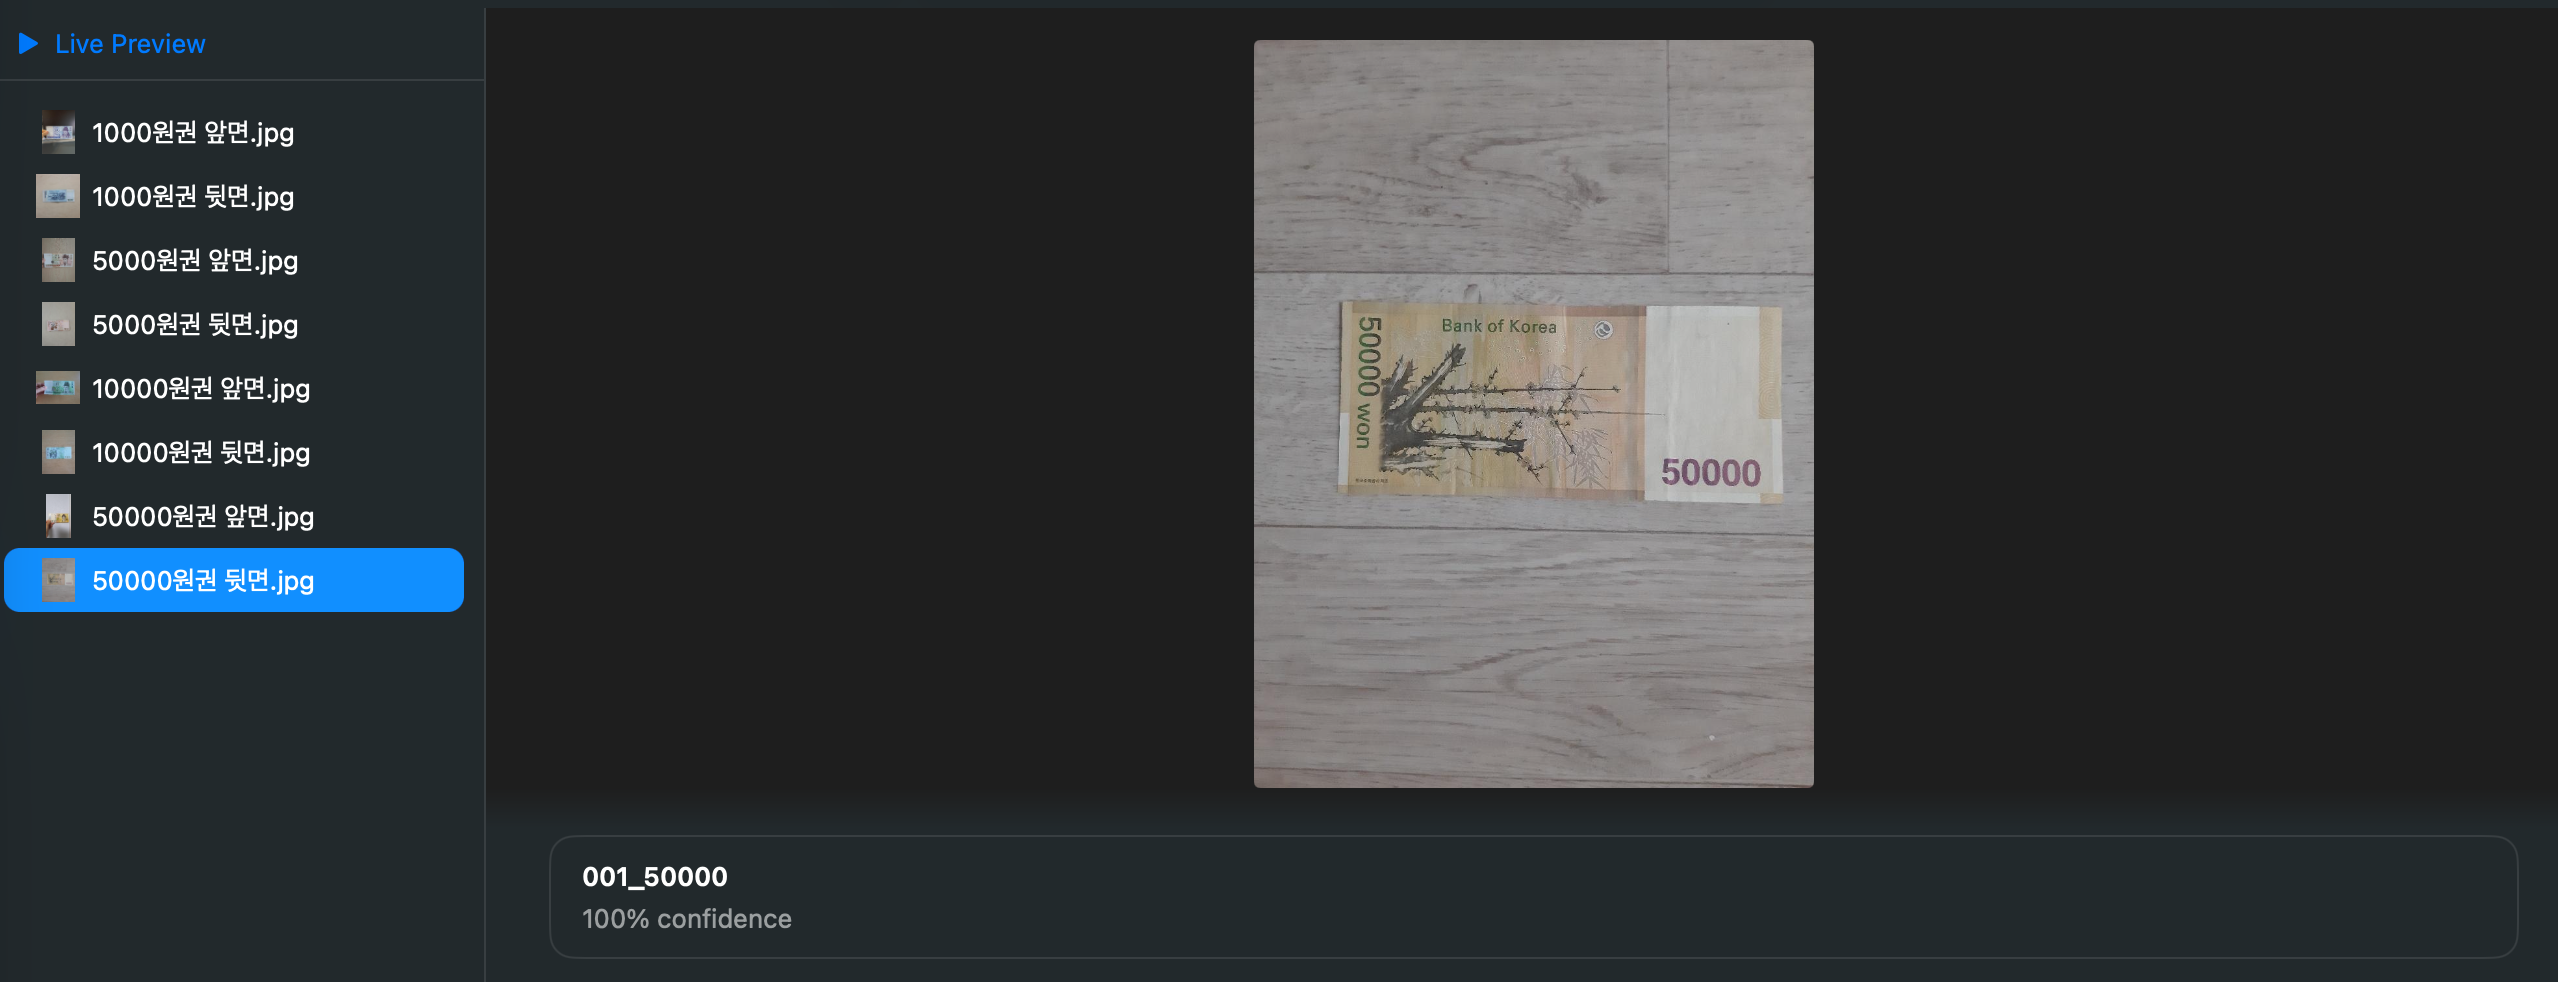
- Preview 결과
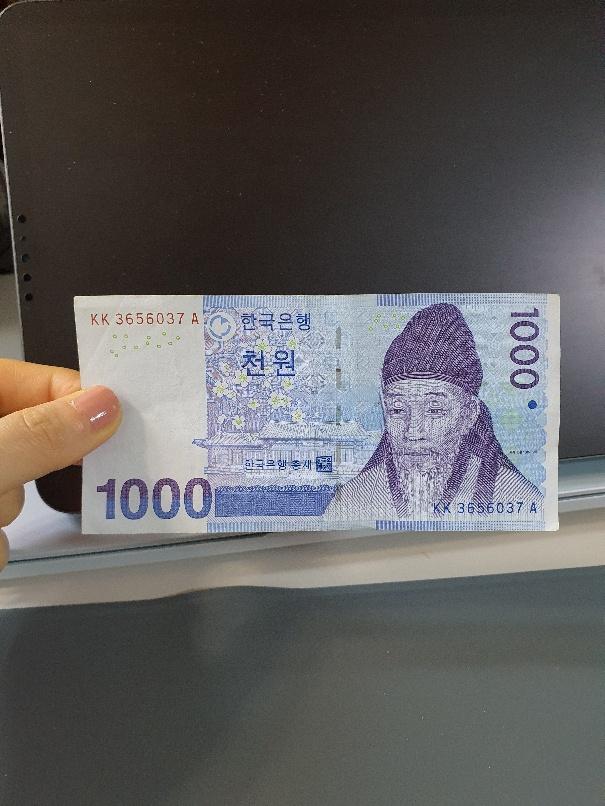
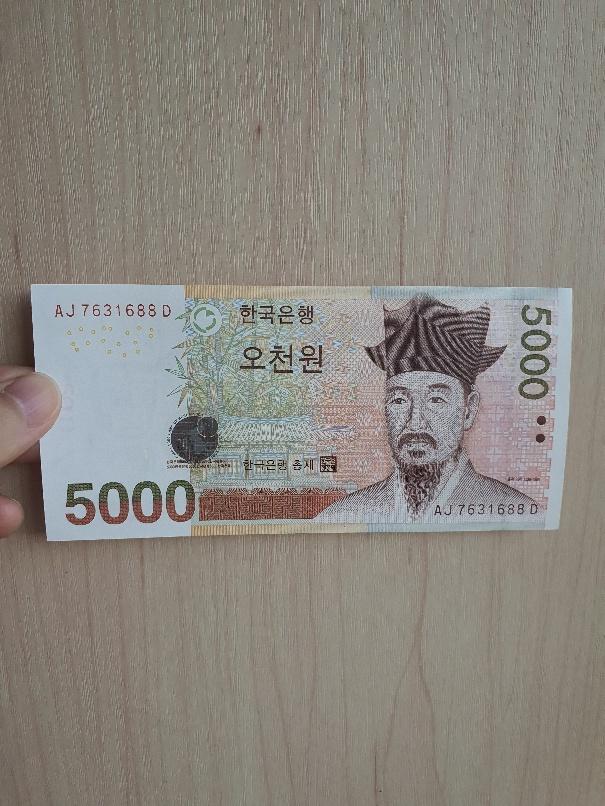
📌 2. 두 번째 모델 (9:0.5:0.5)
- 원본 데이터셋 : 1000, 5000, 10000, 50000원권 이미지 약 1만장
- Feature Extractor: Image Feature Print V2
- Training, Vaildation, Testing 비율 :
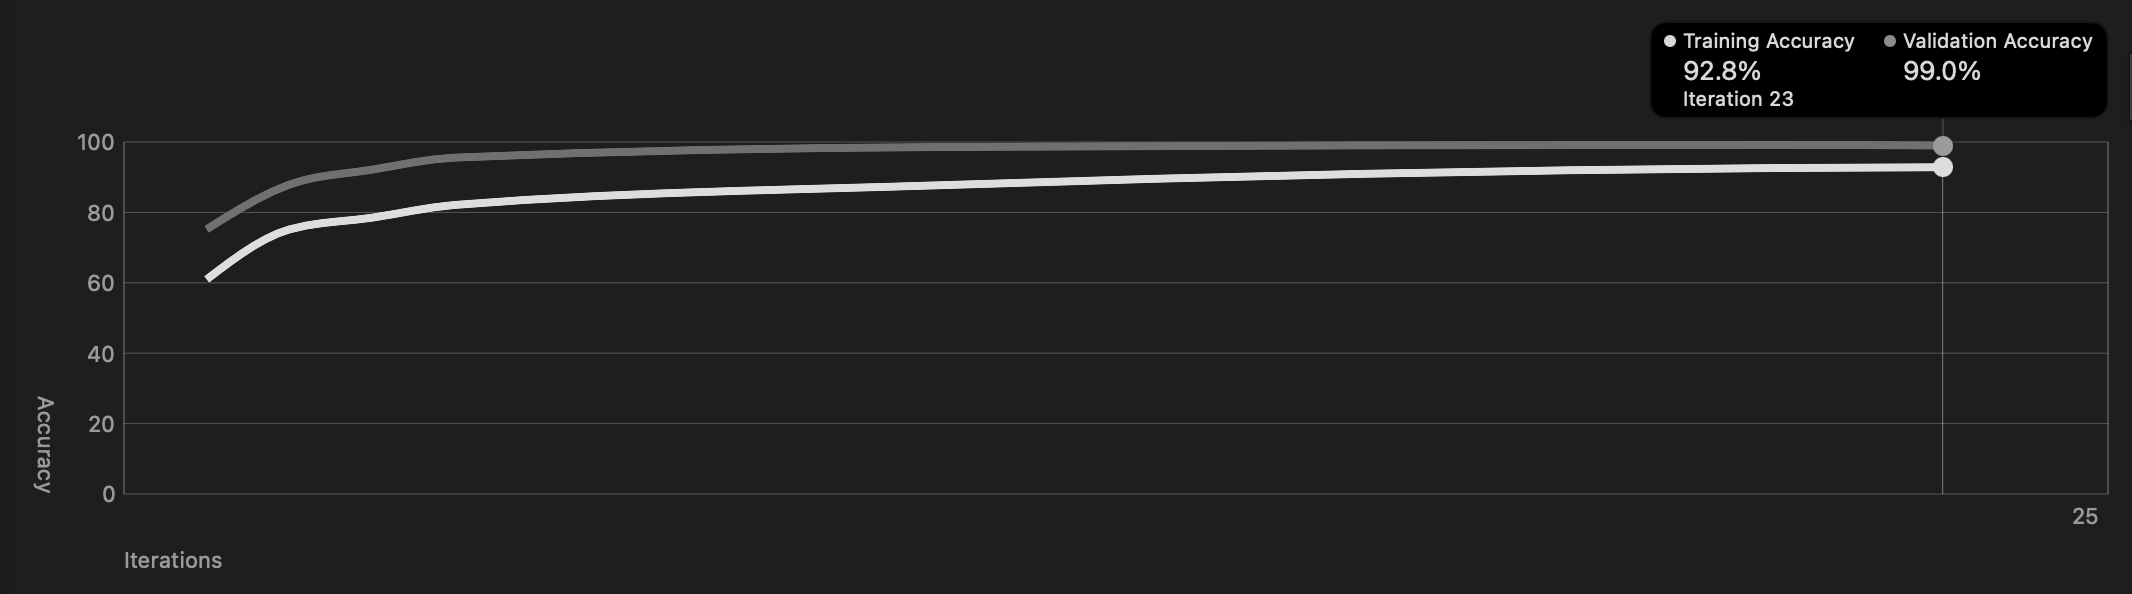
(9:0.5:0.5) - Iterations : 25
- Augmentations : Add Noise, Blur, Crop, Expose, Rotate +
Flip
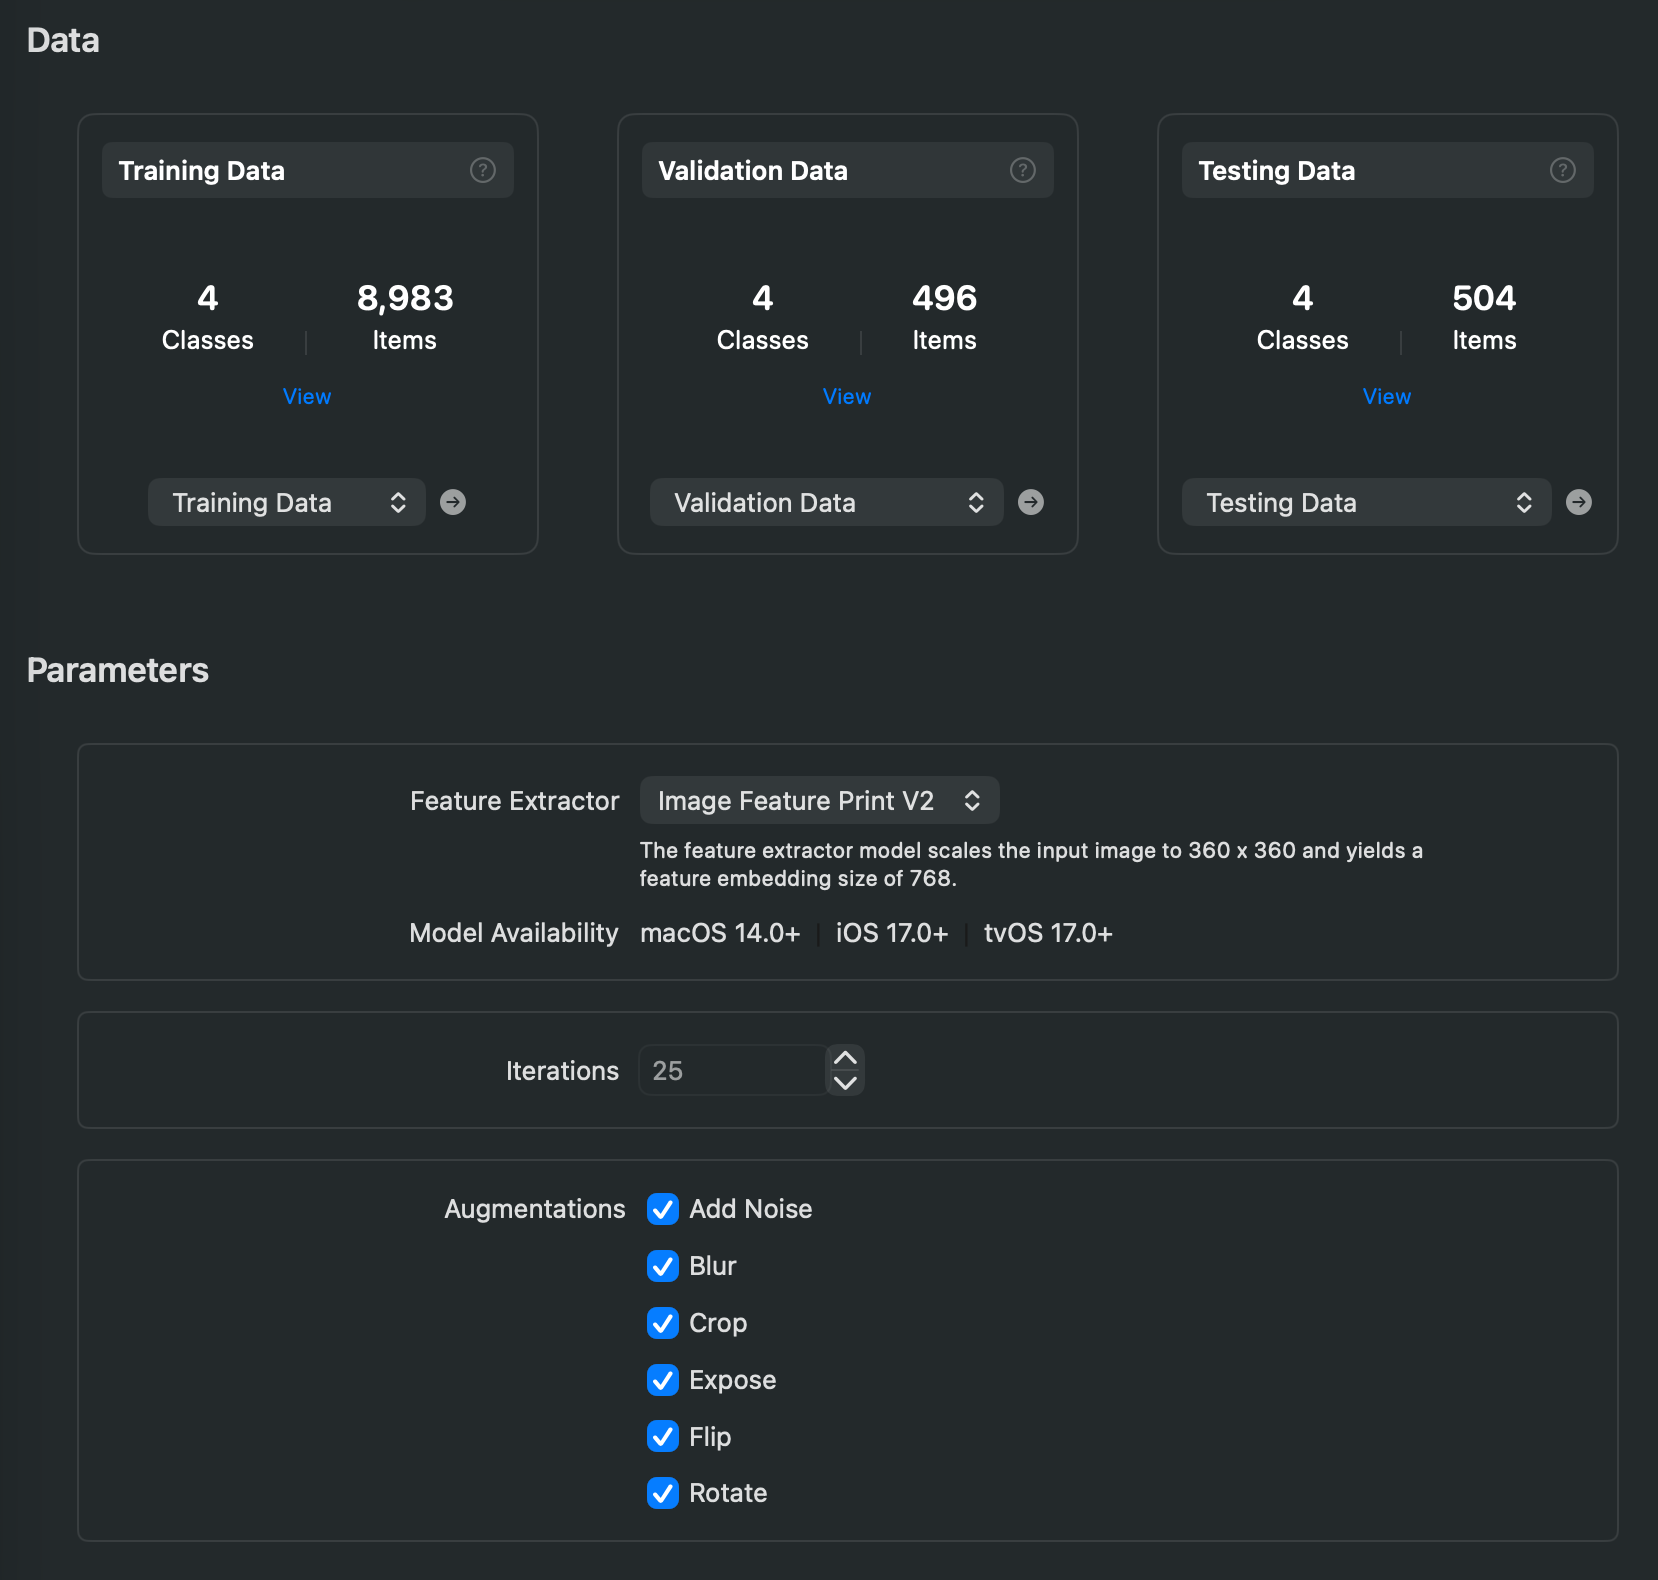
- 모델 훈련 결과
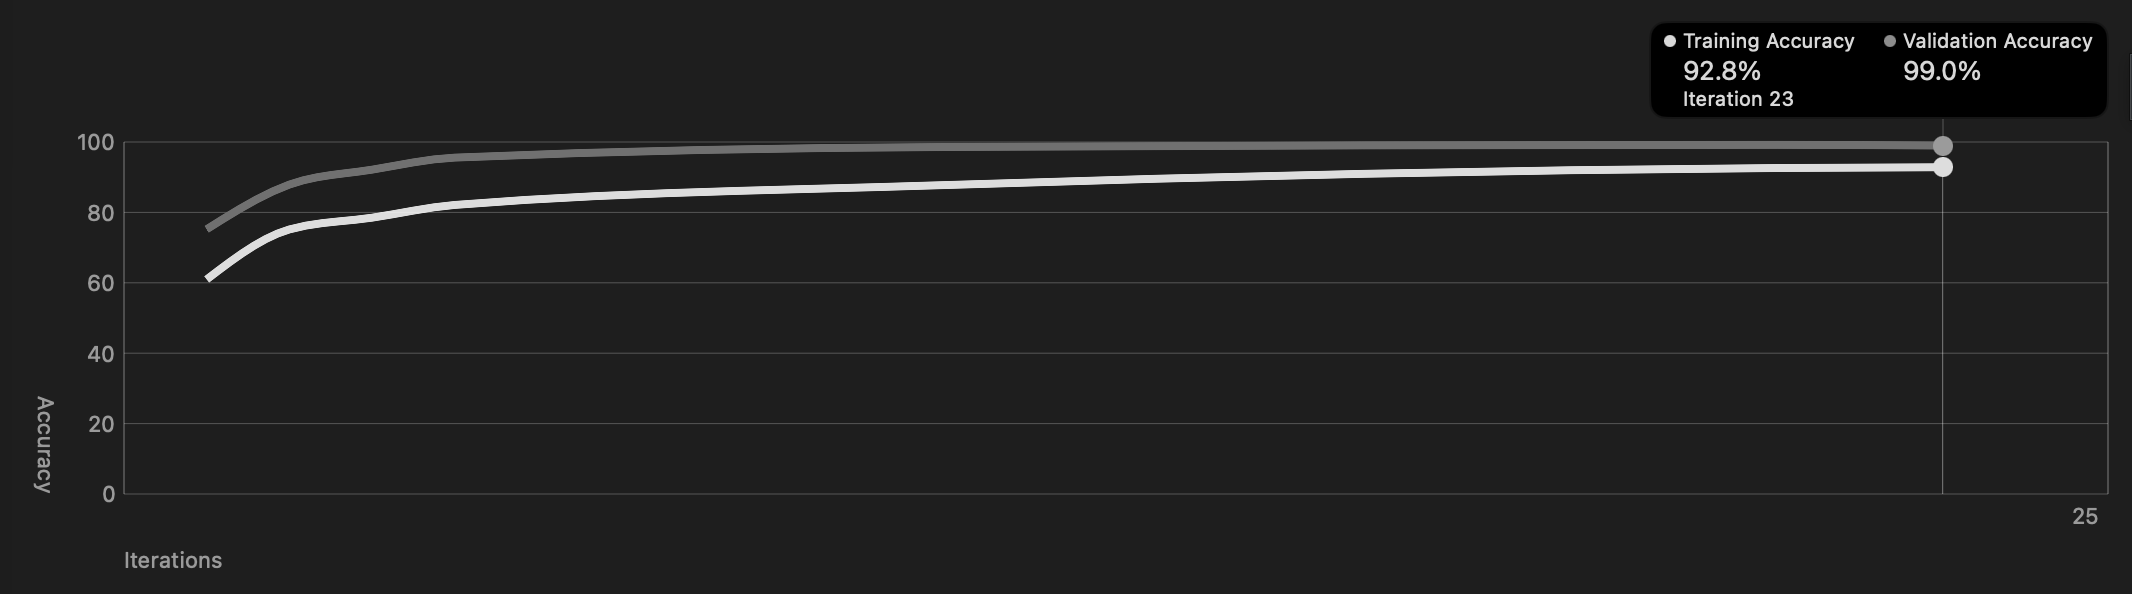
- 훈련 정확도(Training Accuracy) : 92.8% (첫 번째 모델: 91.8%)
- 검증 정확도(Validation Accuracy) : 99.0% (첫 번째 모델: 98.9%)
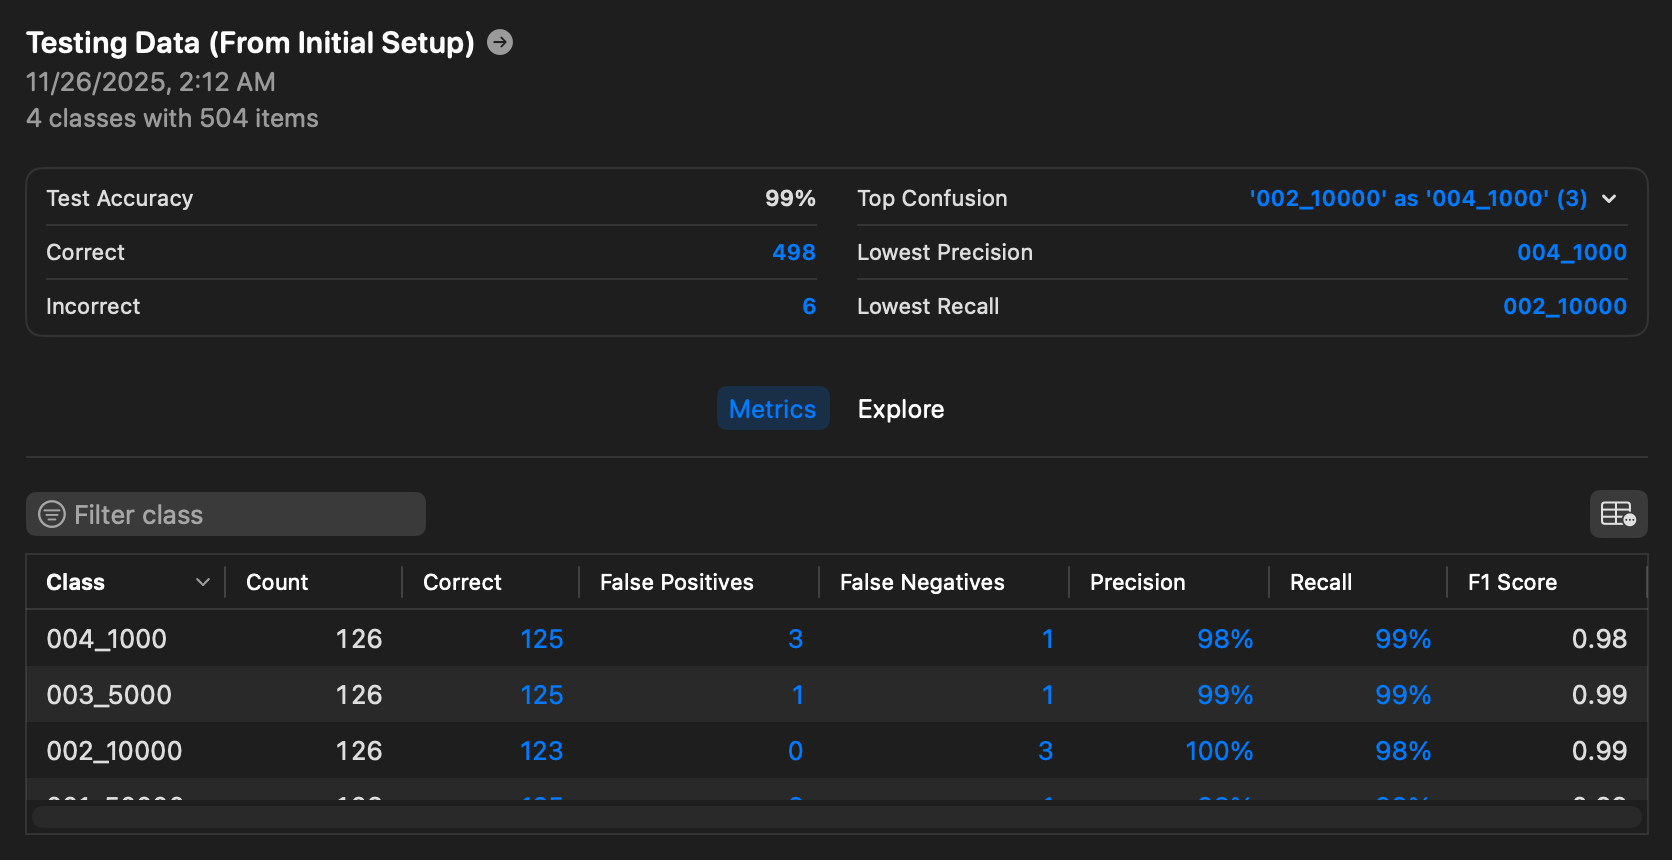
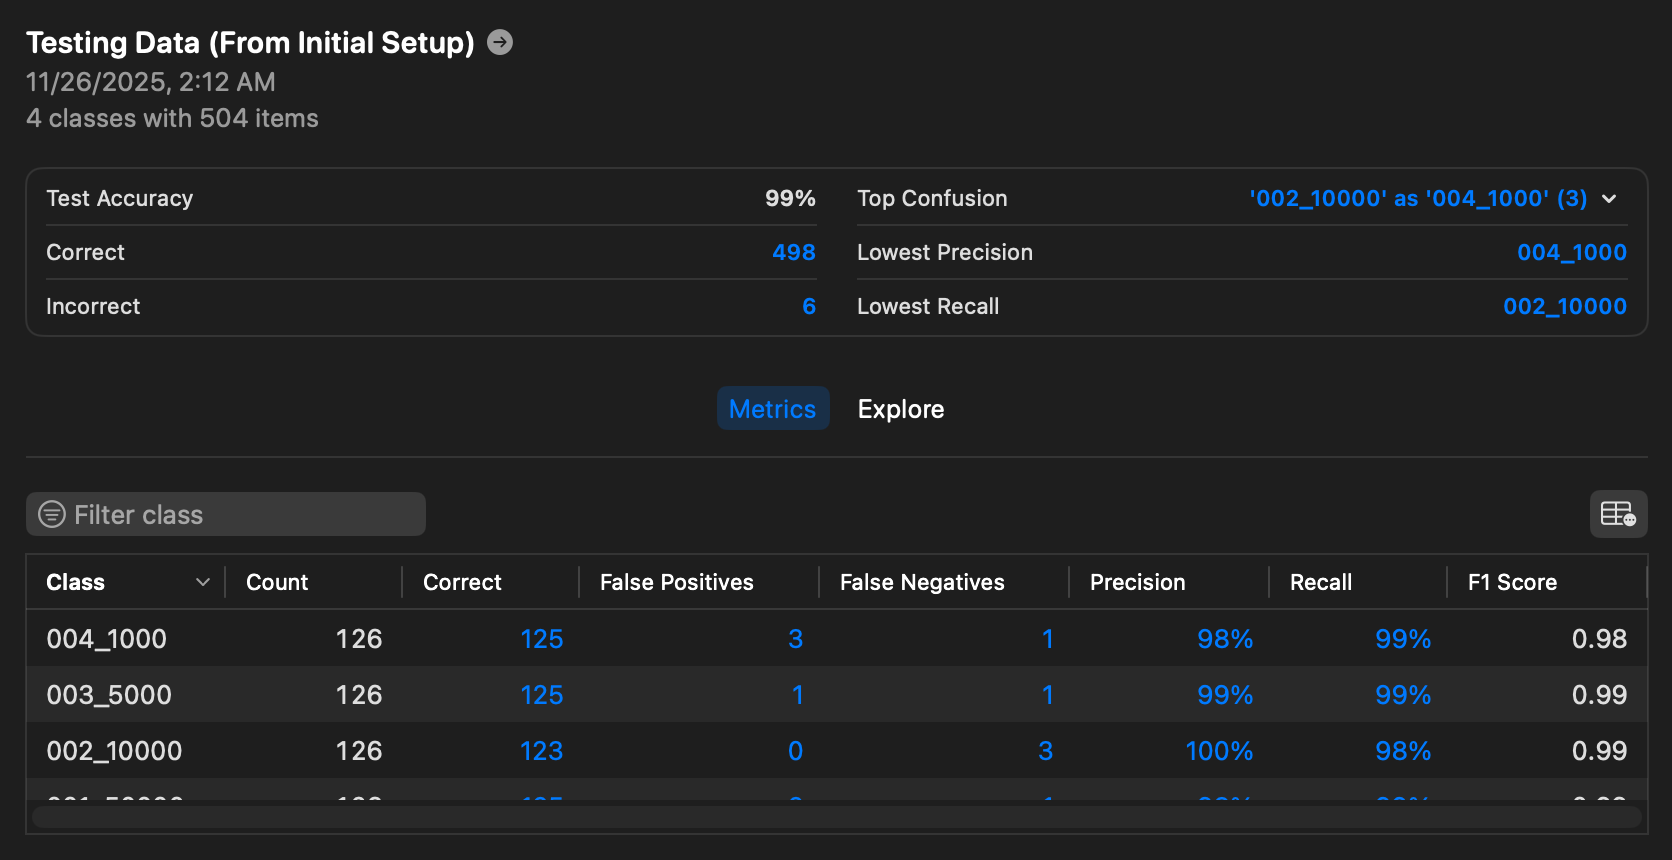
- 테스트 결과(테스트 셋으로 테스트 진행, 약 500장)
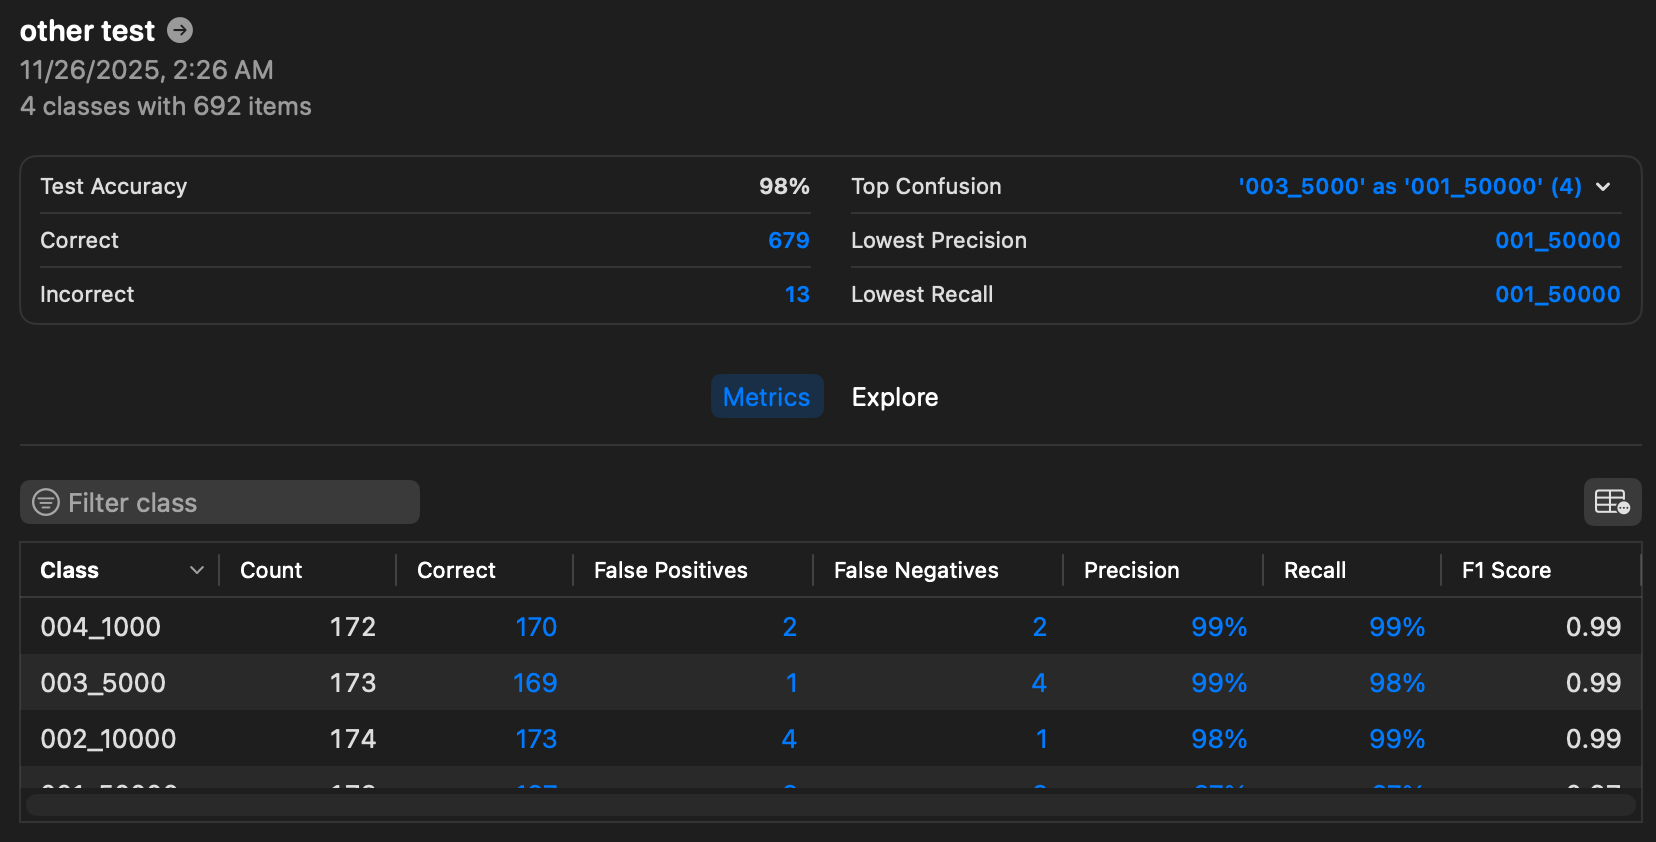
- 테스트 결과(기타 데이터셋 약 700장)
- Preview 결과
📌 3. 세 번째 모델 (7:1.5:1.5)
- 원본 데이터셋 : 1000, 5000, 10000, 50000원권 이미지 약 1만장
- Feature Extractor: Image Feature Print V2
- Training, Vaildation, Testing 비율 :
(7:1.5:1.5) - Iterations : 25
- Augmentations : Add Noise, Blur, Crop, Expose, Rotate +
Flip
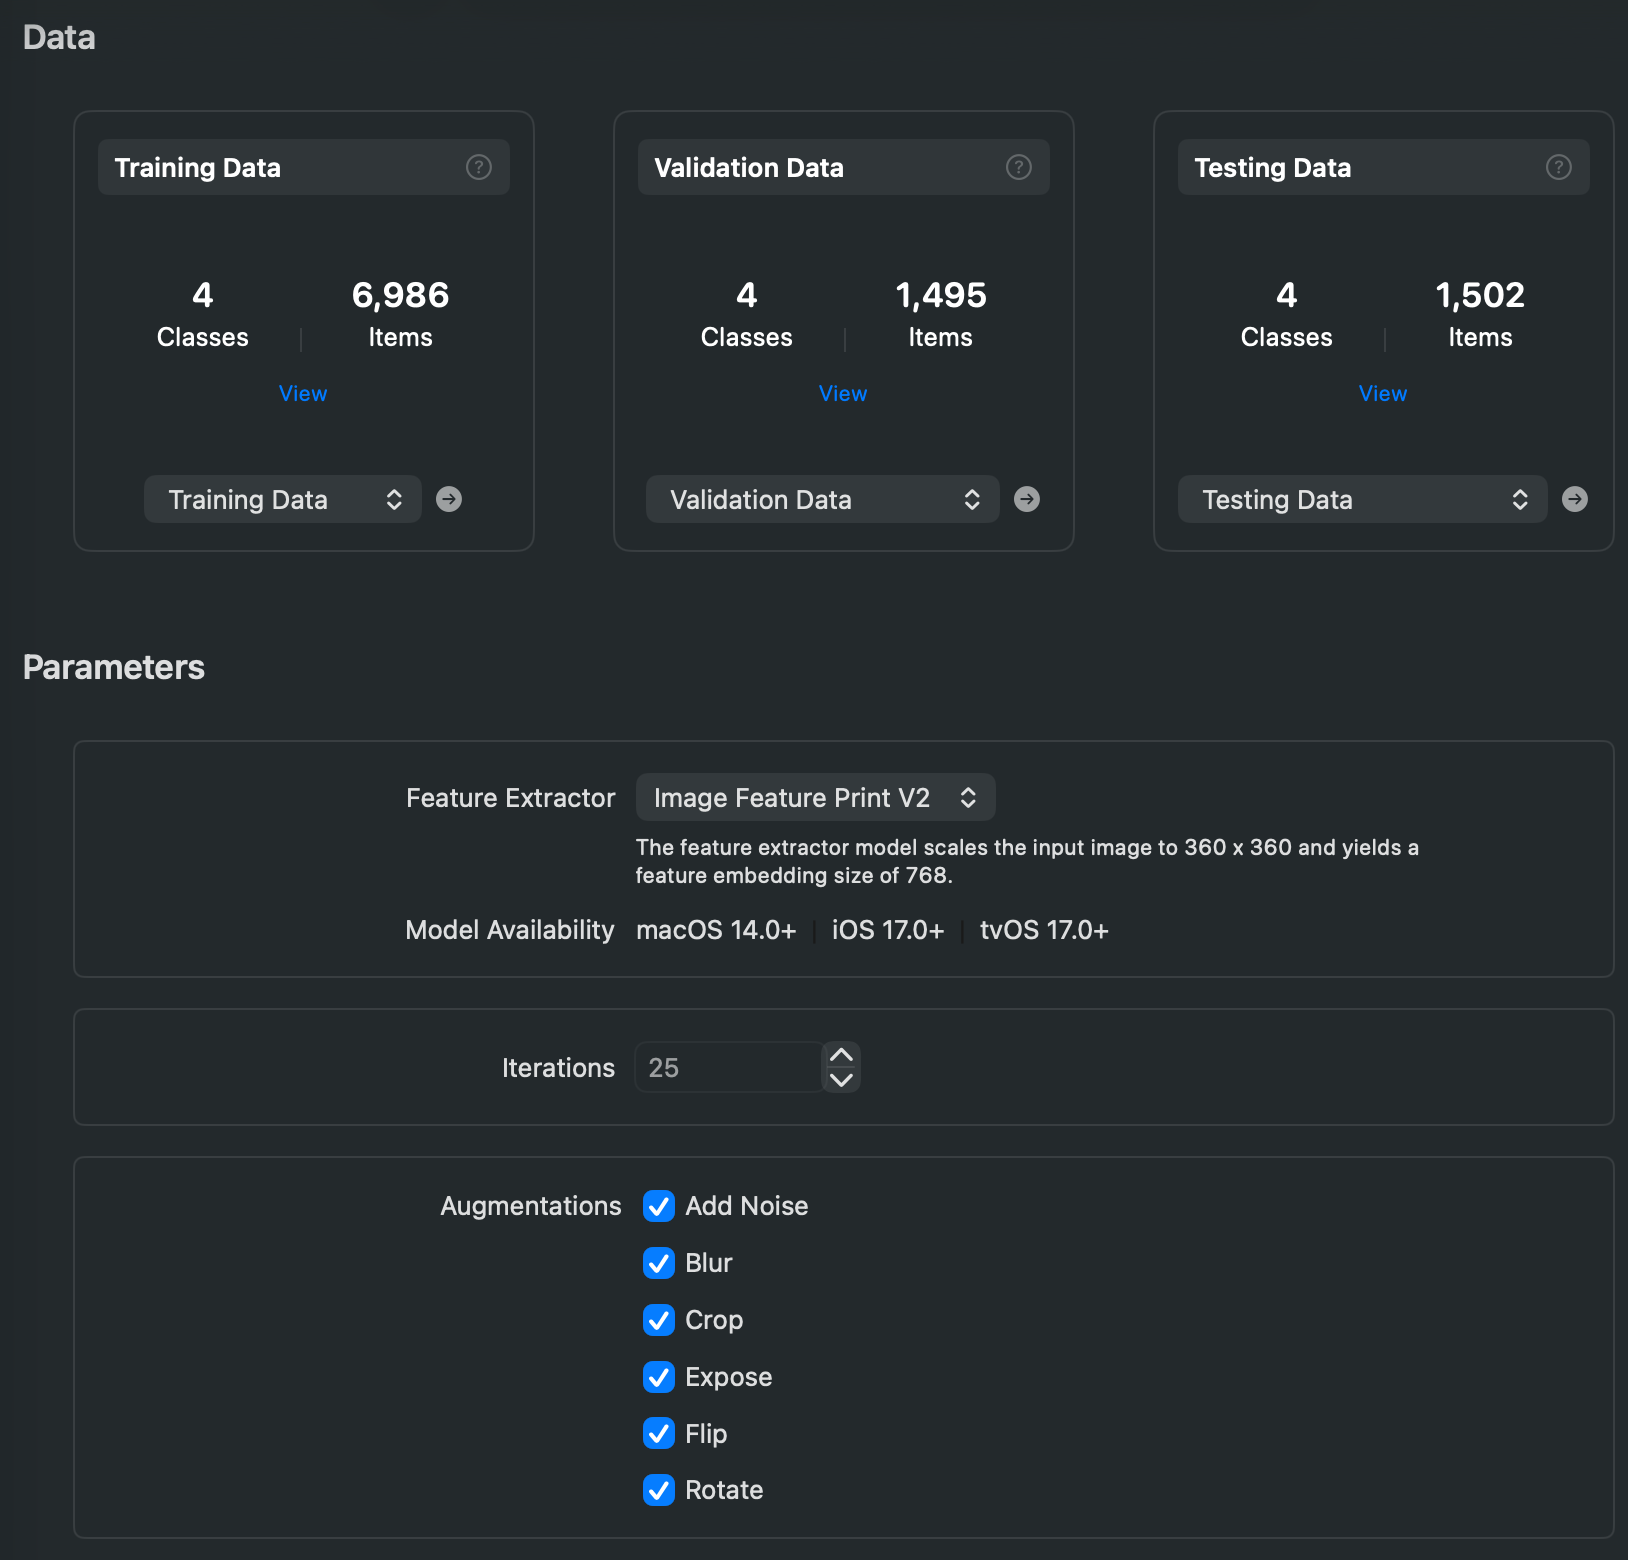
- 모델 훈련 결과
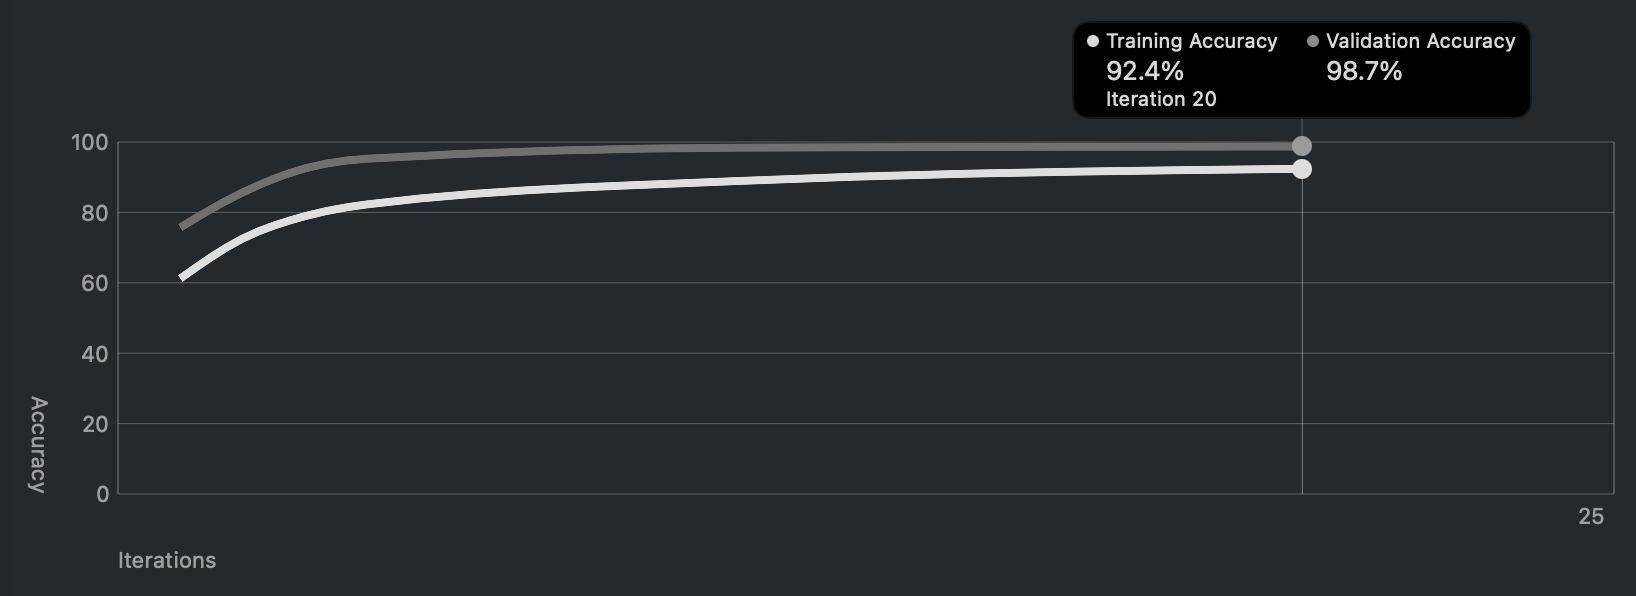
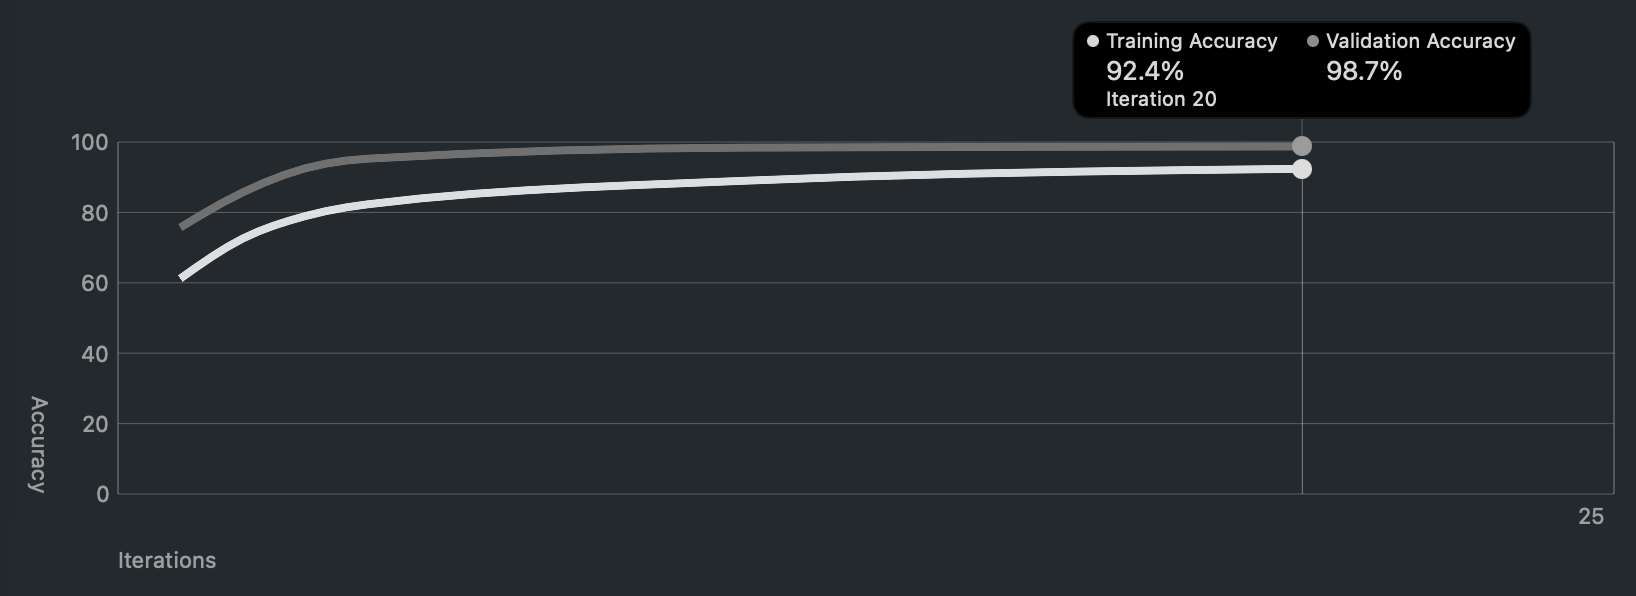
- 훈련 정확도(Training Accuracy) : 92.4% (첫 번째 모델: 91.8%, 두 번째 모델: 92.8%)
- 검증 정확도(Validation Accuracy) : 98.7% (첫 번째 모델: 98.9%, 두 번째 모델: 99.0%)
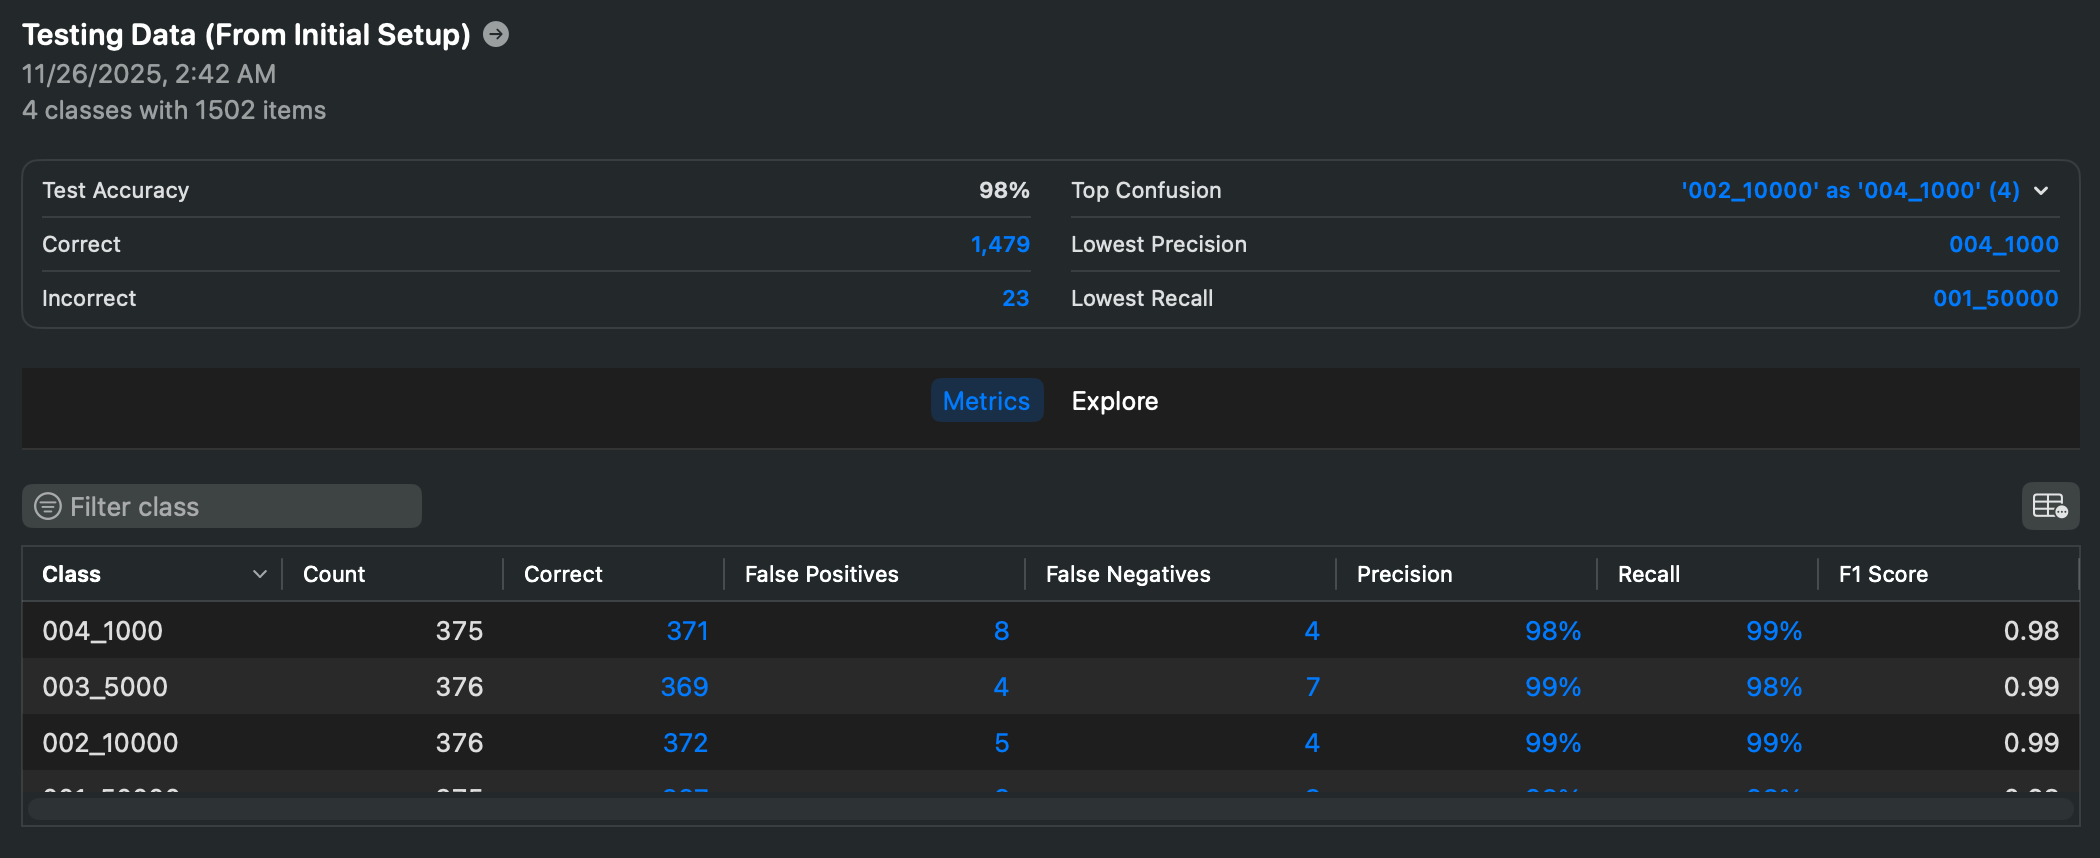
- 테스트 결과(테스트 셋으로 테스트 진행, 약 1500장)
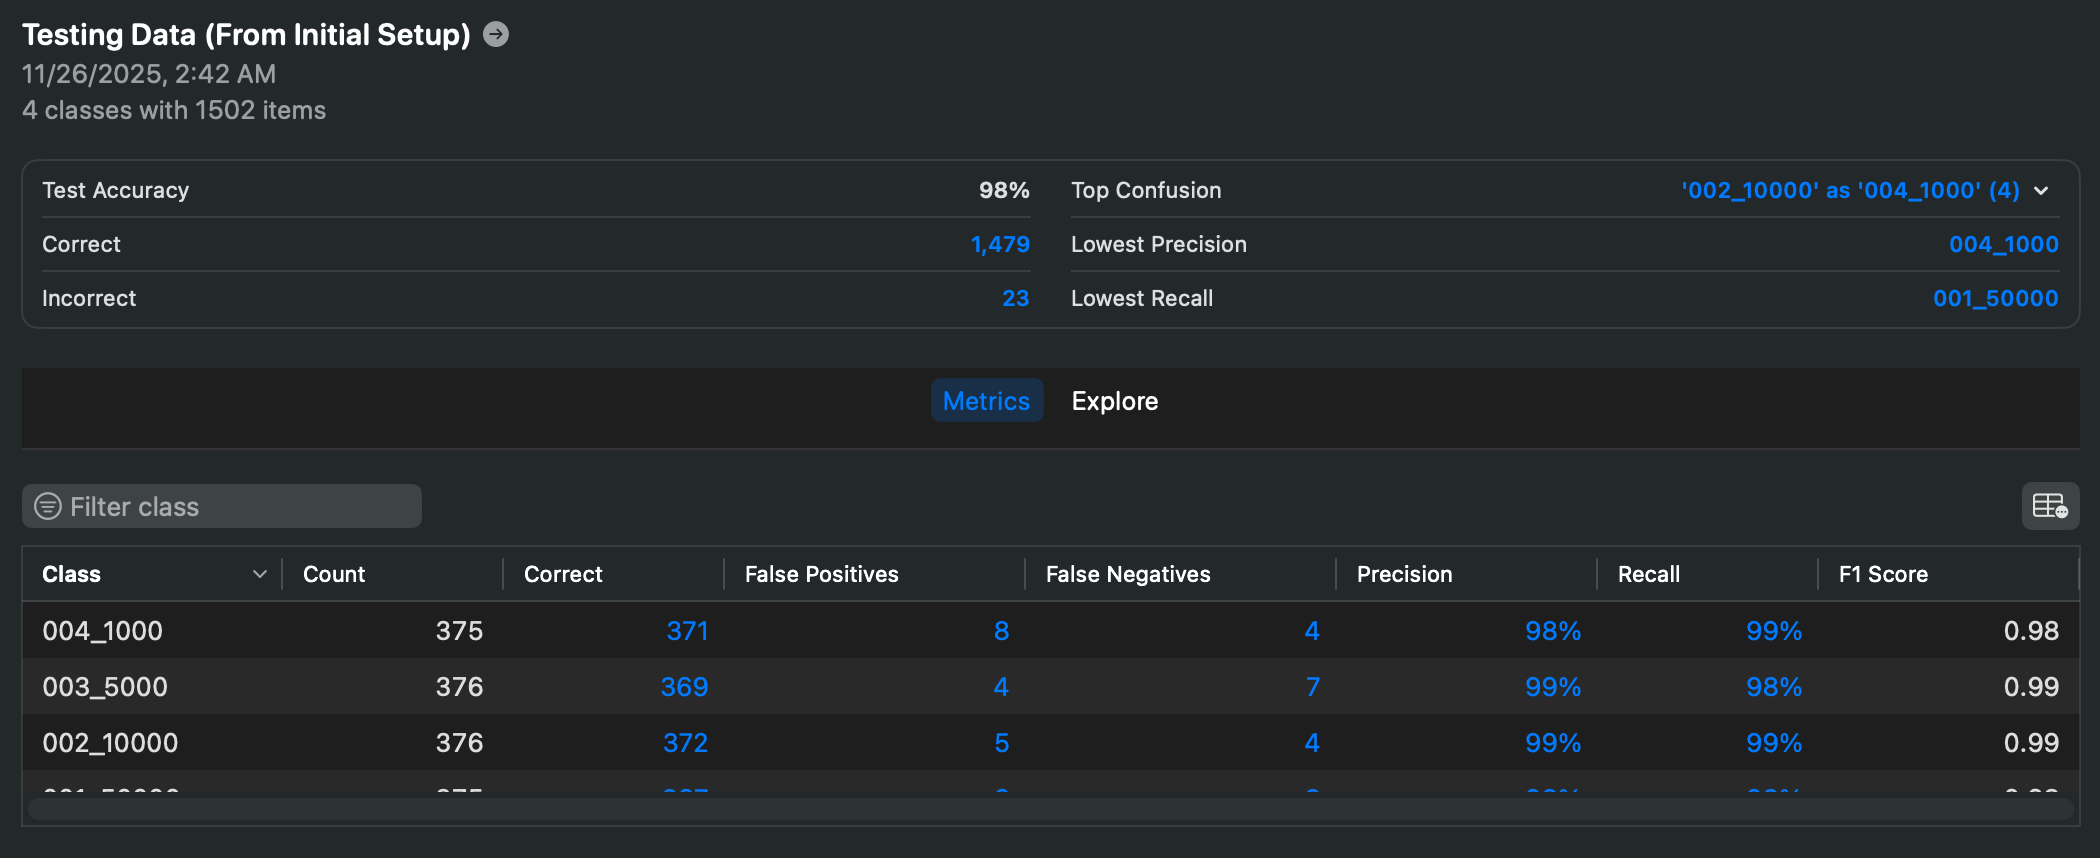
- 테스트 결과(기타 데이터셋 약 700장)
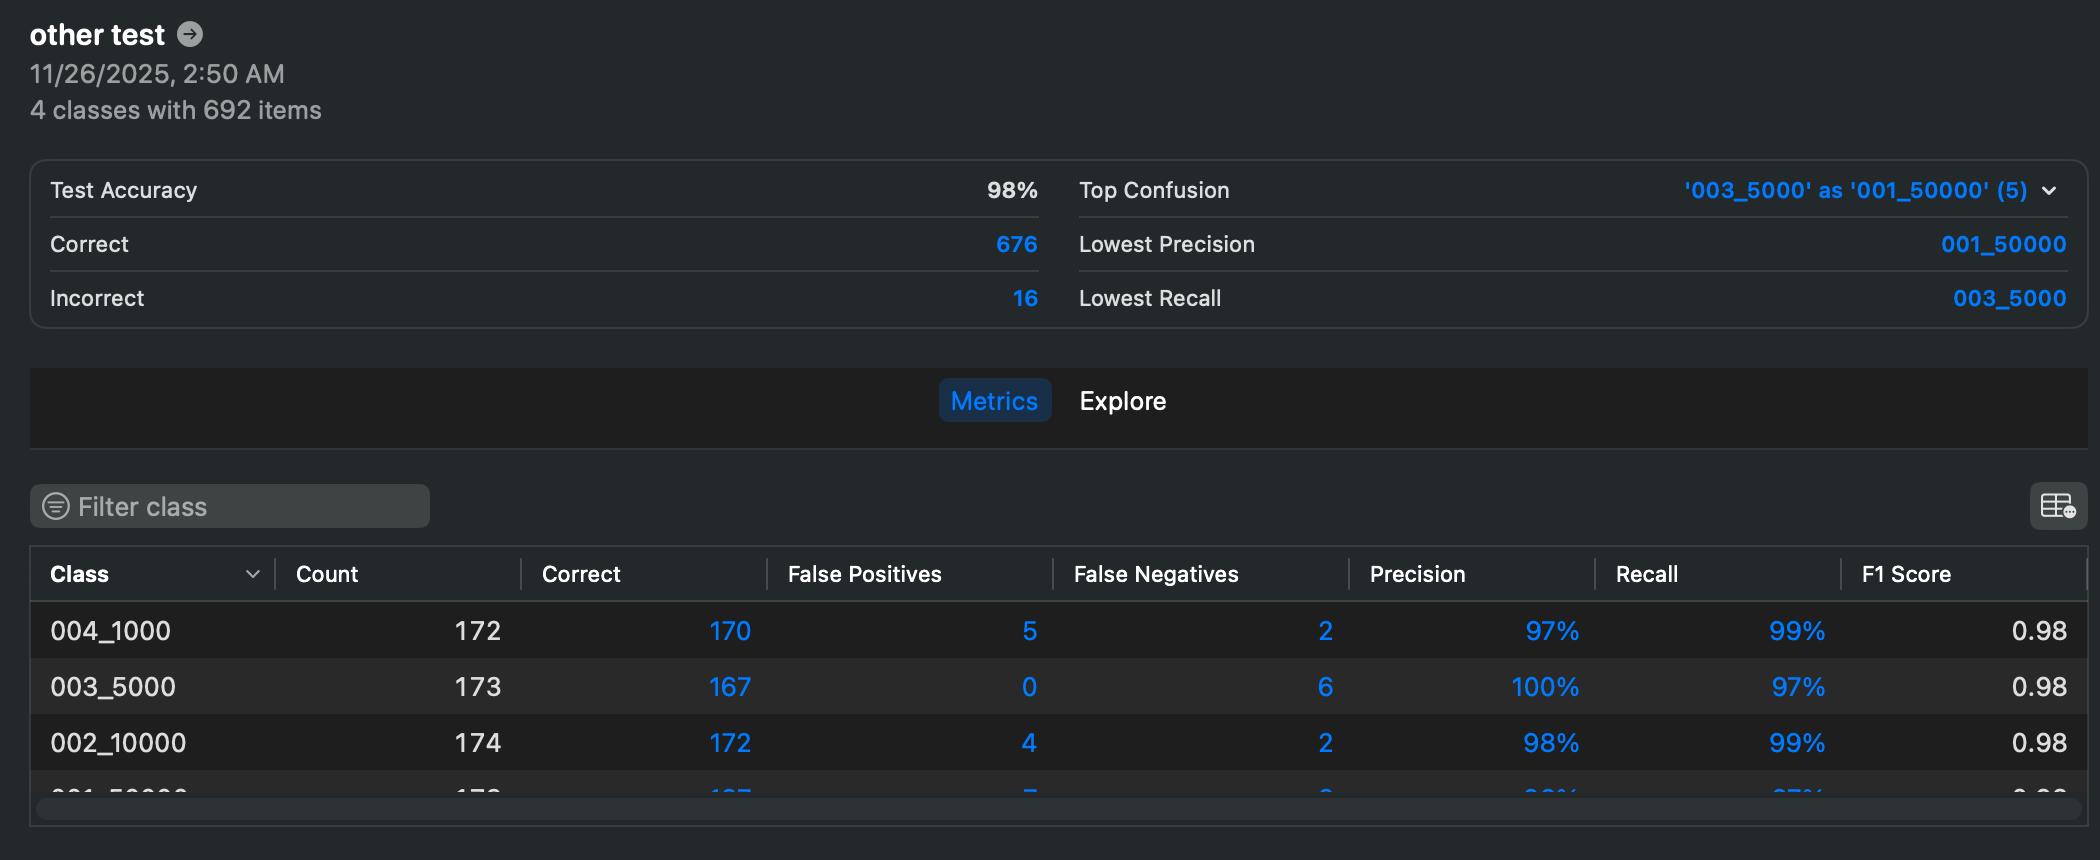
- Preview 결과
🧪 성능 비교
💡 첫 번째 모델 (8:1:1)
- Training Accuracy: 91.8%
- Validation Accuracy: 98.9%
💡 세 번째 모델 (7:1.5:1.5)
- Training Accuracy: 92.4%
- Validation Accuracy: 98.7%
💡 첫 번째 모델 (8:1:1)
- Training Accuracy: 91.8%
- Validation Accuracy: 98.9%
💡 세 번째 모델 (7:1.5:1.5)
- Training Accuracy: 92.4%
- Validation Accuracy: 98.7%
💡 두 번째 모델 (9:0.5:0.5)
- Training Accuracy: 92.8%
- Validation Accuracy: 99.0%
💡 네 번째 모델은 미정..ㅎㅎ
결론
첫 번째 모델 (8:1:1)
두 번째 모델 (9:0.5:0.5)
세 번째 모델 (7:1.5:1.5)
두 번째 모델이 성능이 가장 높게 나옴.
모든 모델이 전반적으로 프리뷰에서 과반수가 99% 이상 일치함을 표시했음.
→ 두 번째 모델을 사용하는 게 좋을 것 같음.